Karta referencyjna od AI Sandbox Lab dla uczestników grup praktycznych.
- Dla kogo: Product Managerów, Project Managerów, analityków biznesowych, QA, Engineering Managerów i każdego, kto pracuje z AI bez wykształcenia technicznego
- Czas czytania: około 15 minut
- Źródła: badania i dokumentacja, linki sprawdzone 2 listopada 2026; liczby w nawiasach kwadratowych prowadzą do listy na końcu
Mapa tej karty
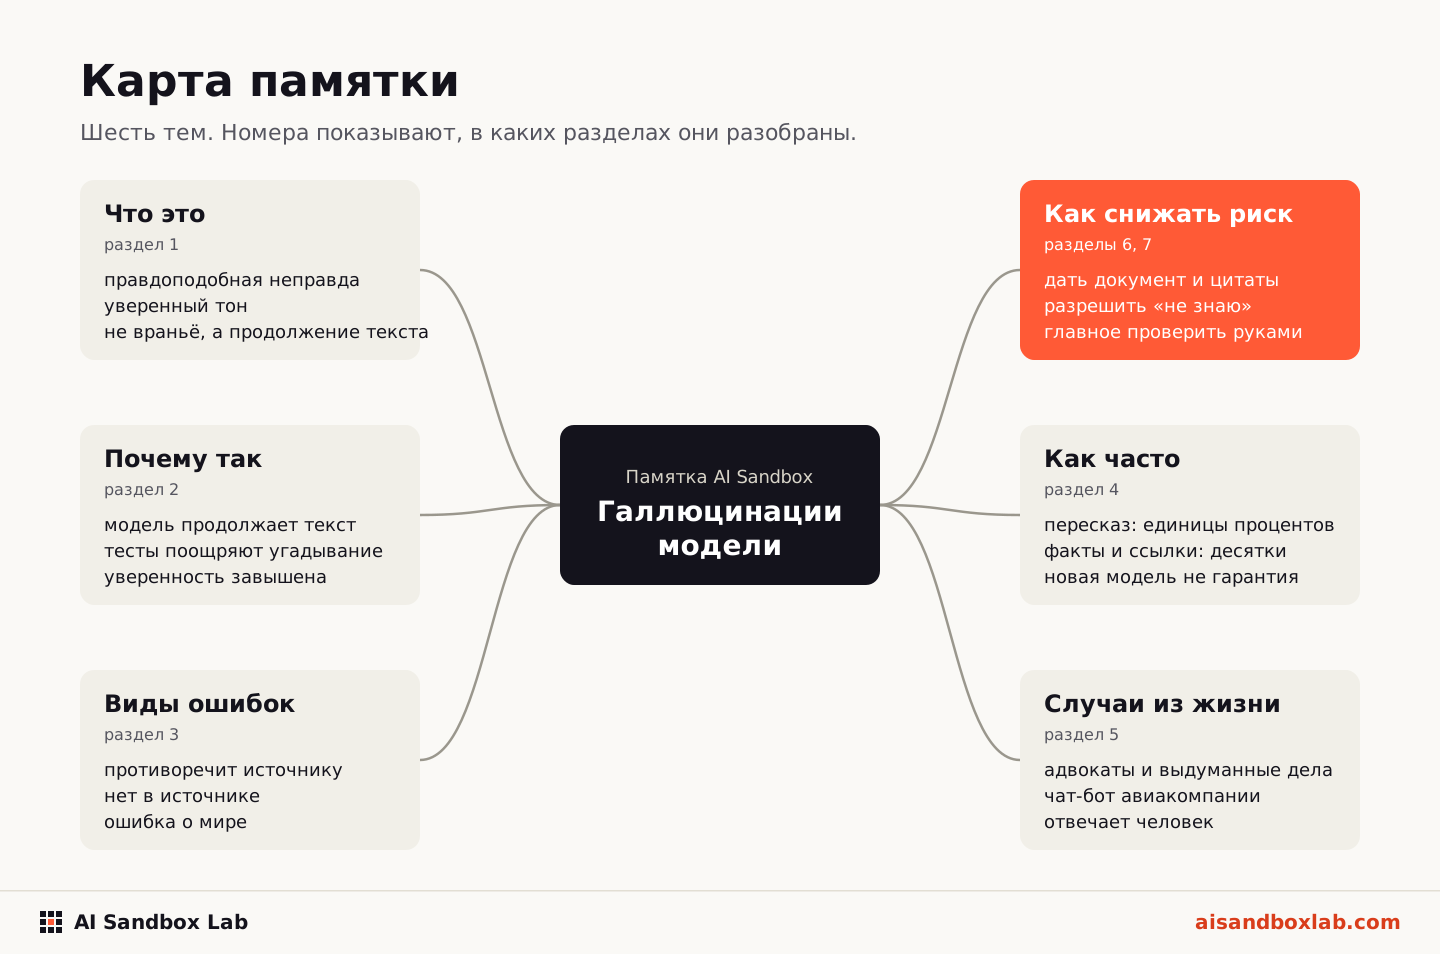
Wersja skrócona: gładki tekst to nie fakt
Czasem model produkuje wiarygodnie brzmiącą nieprawdę: dokładną liczbę, która nie istnieje, link do artykułu, którego nigdy nie napisano, cytat, którego nikt nie powiedział. To nie jest wada jednej konkretnej usługi. Wynika z tego, jak modele są budowane i trenowane. Nie da się tego usunąć w całości, ale ryzyko można mocno obniżyć: dać modelowi swój dokument, pozwolić mu powiedzieć „nie wiem", wymagać cytatów i sprawdzać ręcznie najważniejsze fragmenty. Im większy koszt błędu, tym surowsze sprawdzanie.
1. Czym jest halucynacja
Halucynacja modelu to wiarygodnie brzmiąca, pewnie podana odpowiedź, która nie zgadza się z rzeczywistością albo z danymi źródłowymi. Badacze opisują to podobnie: model produkuje tekst „wiarygodny, ale niezgodny z faktami" [3].
Samo słowo nie jest do końca trafne. U człowieka halucynacja to postrzeganie czegoś, czego nie ma. Model nie ma ani percepcji, ani zamiaru kłamania. Autorzy jednej z kluczowych prac zaznaczają wprost, że to zjawisko jest „zasadniczo inne" niż doświadczenie człowieka [1]. Dlatego dalej będziemy mówić prościej: model wyprodukował wiarygodną nieprawdę.
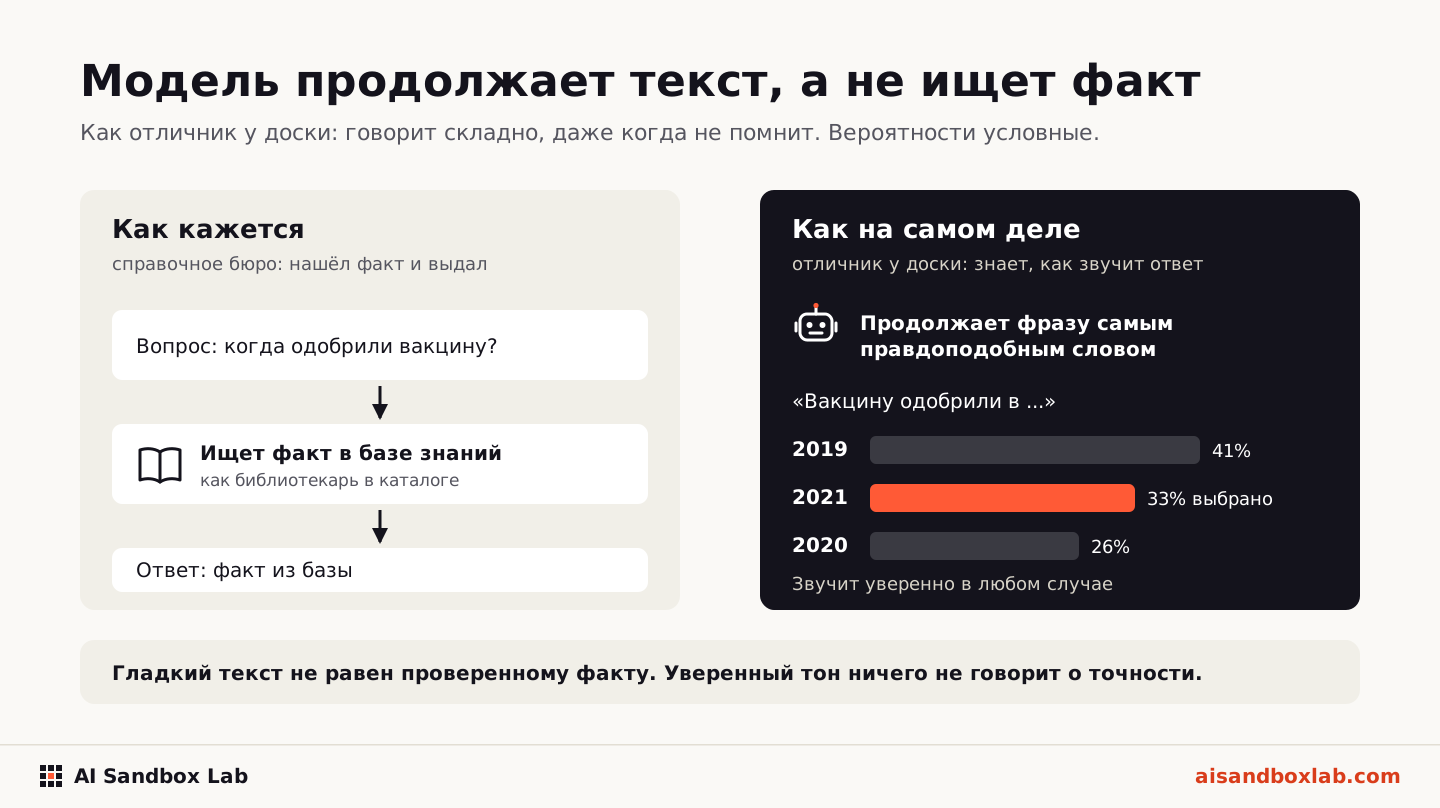
Warto wiedzieć Codzienna analogia: uczeń przy tablicy
Wyobraź sobie ucznia, który nauczył się, jak brzmią poprawne odpowiedzi, ale nie pamięta faktów. Został wywołany do tablicy i wie, że milczenie nie wchodzi w grę: pusta odpowiedź jest oceniona gorzej niż próba. Mówi płynnie, pewnym tonem, we właściwej terminologii. Czasem trafia, czasem nie, i po intonacji nie da się tego rozpoznać. Model działa podobnie: kontynuuje tekst w taki sposób, w jaki takie teksty zwykle brzmią, zamiast sprawdzać bazę faktów.
2. Dlaczego model tak robi
Krótko: trzy powody.
1. Model uczy się przewidywać tekst, a nie przechowywać fakty. Widział ogromną ilość tekstu i nauczył się go wiarygodnie kontynuować. Jeśli jakiś fakt pojawił się w treningu rzadko albo tylko raz, model zna go słabo. Praca teoretyczna Kalai i Vempali pokazuje, że nawet przy idealnych danych treningowych częstość błędów dla takich rzadkich faktów jest w przybliżeniu równa udziałowi faktów widzianych w treningu dokładnie raz [4]. To wynik matematyczny dla modelu idealizowanego, a nie bezpośredni pomiar konkretnego produktu.
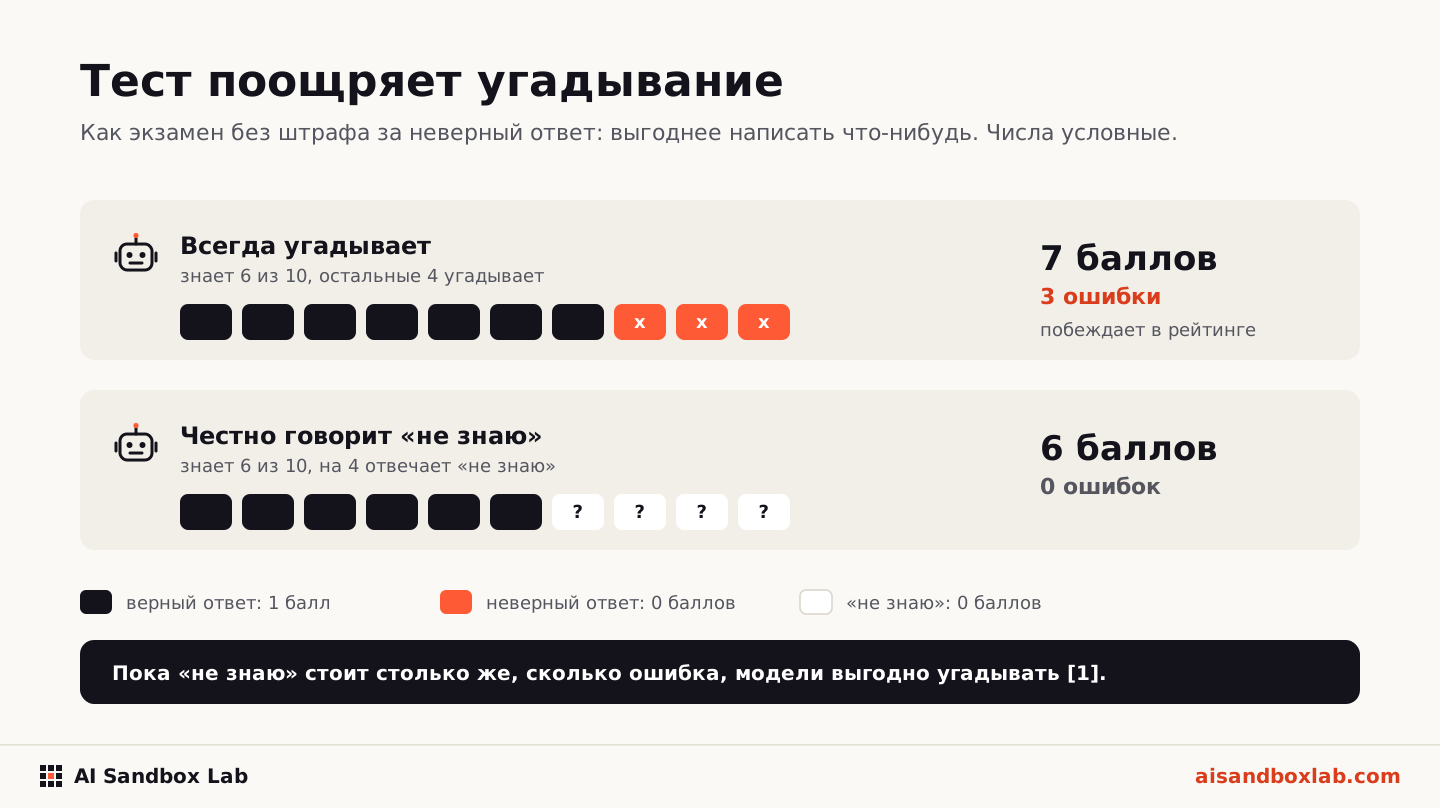
2. Trening i ewaluacje nagradzają zgadywanie. To główny wniosek z niedawnej pracy badaczy OpenAI „Why Language Models Hallucinate" (2025). Większość testów porównujących modele daje 1 punkt za poprawną odpowiedź i 0 za „nie wiem". Wtedy model, który zawsze zgaduje, wypada lepiej niż model, który uczciwie przyznaje, że nie wie. Autorzy piszą, że trening i ewaluacja „nagradzają zgadywanie zamiast przyznawania się do niepewności" [1]. To jak uczeń na egzaminie bez kary za złe odpowiedzi: opłaca się coś wpisać.
3. Model słabo ocenia własną pewność. W teście SimpleQA (4326 krótkich pytań faktograficznych) autorzy poprosili model o podanie pewności odpowiedzi. Wynik: pewność modelu jest powiązana z trafnością, ale modele „konsekwentnie ją zawyżają" [5].
Warto wiedzieć Dwa słowa, które spotkasz w badaniach
Kalibracja to stopień, w jakim pewność odpowiedzi zgadza się z jej rzeczywistą trafnością. Dobrze skalibrowany model, który mówi „jestem pewien na 70%", ma rację w około 70% przypadków. Benchmark to standardowy zestaw pytań używany do porównywania modeli, jak wspólny egzamin.
3. Rodzaje halucynacji
Przeglądy naukowe najczęściej dzielą je na dwa sposoby.
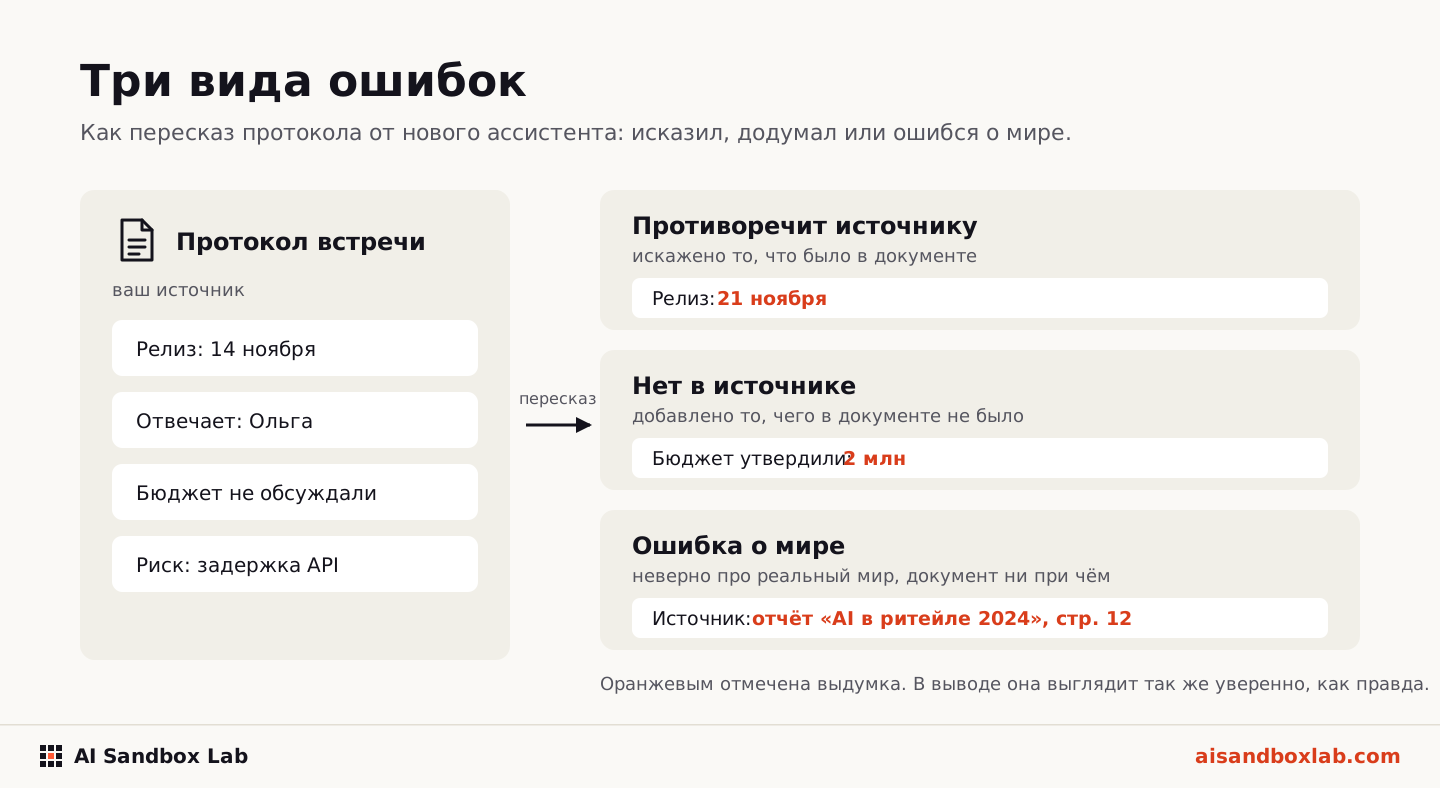
Po pierwsze: ze względu na relację do tego, co dostał model. To klasyfikacja z przeglądu Ji i współautorów [2].
- Sprzeczność ze źródłem. Dałeś dokument, a model go zniekształcił w streszczeniu. W przeglądzie przykład: tekst mówi, że szczepionkę zatwierdzono w 2019 roku, a streszczenie podaje 2021.
- Brak możliwości sprawdzenia względem źródła. Model dodał coś, czego nie ma w dokumencie. Autorzy zaznaczają, że takie dodatki nie zawsze są błędne, ale wymagają ostrożności, bo nie da się ich zweryfikować na podstawie źródła.
Po drugie: błąd o świecie albo błąd względem zadania. Przegląd Huanga i współautorów dzieli halucynacje na faktograficzne (różnią się od rzeczywistych faktów) i dotyczące wierności (różnią się od Twojego wejścia lub polecenia) [3].
Jak to wygląda w pracy:
| Rola | Przykład | Rodzaj |
|---|---|---|
| Product Manager | Prosisz o streszczenie 20 wywiadów z klientami. W podsumowaniu jest cytat, którego nikt nie powiedział | spoza źródła |
| Product Manager | Prosisz o dane o wielkości rynku. Dostajesz dokładną liczbę z odwołaniem do raportu, który nie istnieje | błąd faktograficzny |
| Project Manager | Prosisz o przeredagowanie protokołu ze spotkania. Termin przesunął się w przeróbce, a właściciel zadania jest błędny | sprzeczność ze źródłem |
| Analityk biznesowy | Prosisz o wyciągnięcie wymagań z regulaminu. Pojawia się punkt, którego nie ma w regulaminie | spoza źródła |
| QA | Prosisz o przypadki testowe z opisu funkcji. Część przypadków sprawdza zachowanie, którego nikt nie obiecał | spoza źródła |
| Engineering Manager | Prosisz o linki do artykułów o praktykach oceny zespołów. Część tytułów i autorów jest zmyślona | błąd faktograficzny |
Ważne
Najbardziej niebezpieczna odpowiedź to nie absurdalna, tylko wiarygodna: właściwy format, pewny ton, prawdziwe nazwiska obok zmyślonych szczegółów. W badaniu zmyślonych referencji bibliograficznych część odniesień do prawdziwych prac zawierała poważne błędy w szczegółach (43% dla GPT-3.5 i 24% dla GPT-4), czyli mieszankę prawdy i fałszu [8].
4. Jak często to się zdarza
Nie ma jednej liczby w rodzaju „model kłamie w N% przypadków". Wskaźnik zależy od zadania, modelu, sposobu sprawdzania i daty. Poniżej przykłady pomiarów. Nie da się ich uśredniać ani porównywać ze sobą, bo zadania są różne.
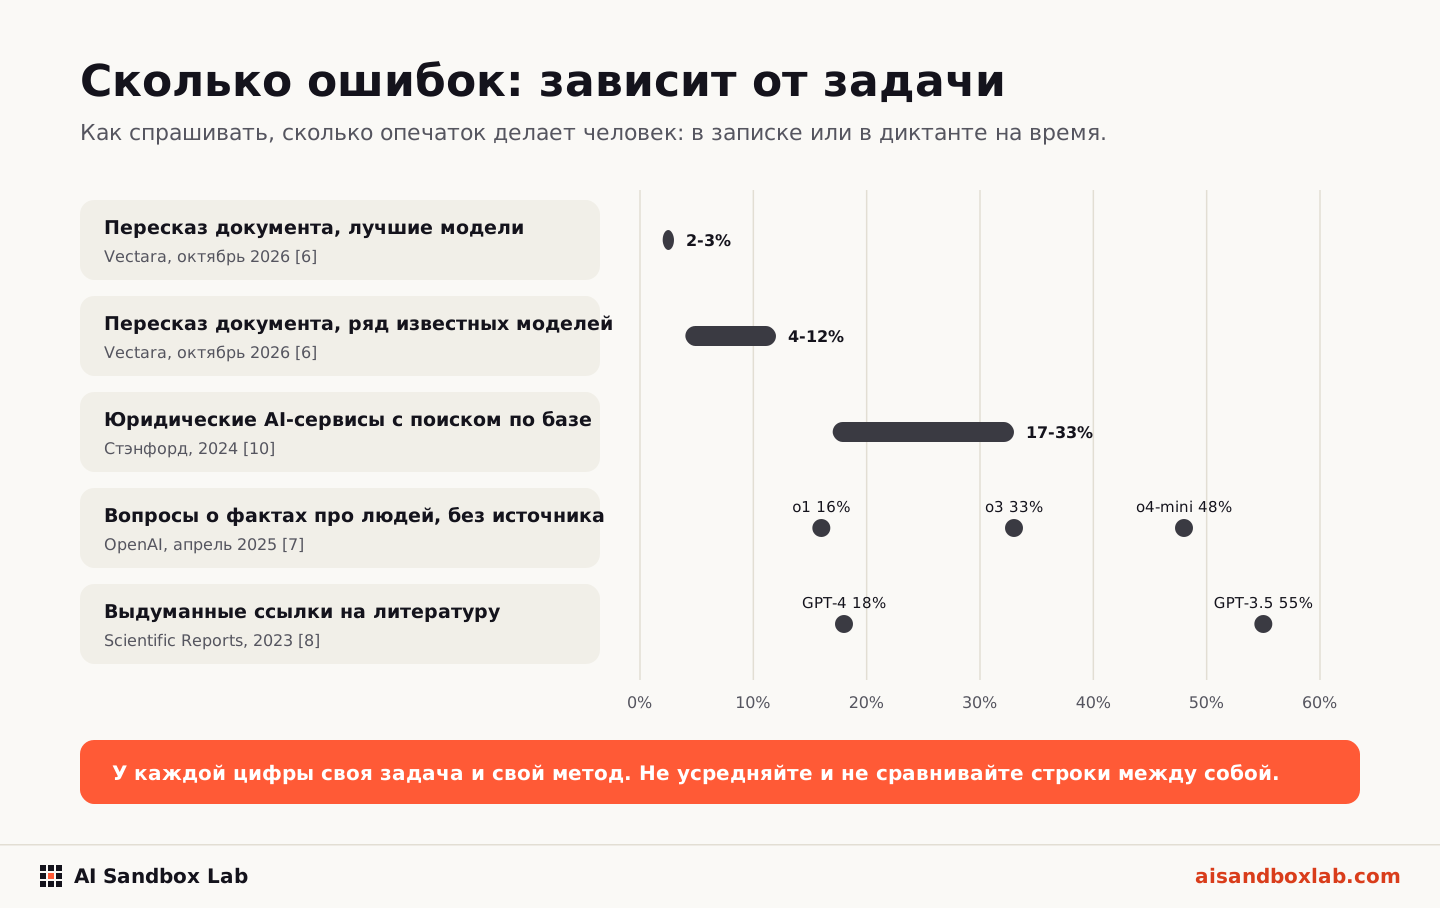
Streszczanie dokumentu (najłagodniejszy warunek). Tabela wyników Vectara mierzy, jak często model dodaje do krótkiego streszczenia dokumentu coś, czego w nim nie ma. Według stanu na 22 października 2026 najlepsze modele w tabeli mają około 2-3%, kilka znanych modeli 4-12%, a jeden model z linii GPT-5 15,1% [6]. Zastrzeżenia: obejmuje to tylko streszczanie krótkich tekstów, zbiór dokumentów jest zamknięty, a ocenia inny model, a nie człowiek.
Pytania faktograficzne bez źródła. W teście PersonQA (pytania o publiczne fakty dotyczące osób), według producenta, model o3 OpenAI mylił się w 33% odpowiedzi, o4-mini w 48%, a wcześniejszy o1 w 16% [7]. Raport pochodzi z kwietnia 2025. To wewnętrzny test producenta.
Odwołania do literatury. W pracy Waltersa i Wildera (2023) ChatGPT napisał krótkie recenzje na 42 tematy, łącznie 636 odniesień. 55% odniesień od GPT-3.5 i 18% od GPT-4 okazało się zmyślonych [8]. Niedawne małe badanie w stomatologii (15 pytań, 2025) wykazało wysoki udział zmyślonych odniesień u GPT-4o, podczas gdy systemy przeszukujące prawdziwe publikacje nie miały zmyślonych odniesień, ale błędnie interpretowały to, co znalazły [9]. Próba jest mała: traktuj to jako ilustrację, a nie szacunek.
Wyspecjalizowane narzędzia prawnicze AI. Zespół ze Stanford przetestował komercyjne usługi badań prawnych reklamowane jako „wolne od halucynacji". Myliły się w 17-33% zapytań [10]. To praca z 2024 roku, wersje produktów od tego czasu się zmieniły.
Ważne zastrzeżenie dla wniosków. Nowsze modele niekoniecznie halucynują mniej. Karta systemowa OpenAI mówi, że o3 formułuje więcej twierdzeń, więc ma więcej zarówno trafnych, jak i błędnych, a badacze jeszcze nie znają przyczyny [7]. W tabeli Vectara gpt-5-high ma 15,1%, a gpt-4o 9,6%, więc nowszy model wypadł na tym zadaniu gorzej [6]. Modele mają różne wersje i daty, więc to obserwacja, a nie prawo. Wniosek: „model jest nowy i mądry" nie zastępuje sprawdzania.
Warto wiedzieć Czy da się sprowadzić to do zera
Według pracy teoretycznej Xu i współautorów halucynacji w modelach językowych nie da się wyeliminować całkowicie [11]. To stwierdzenie matematyczne przy określonych założeniach, ale praktyczny wniosek zgadza się z zaleceniem Anthropic w dokumentacji: techniki znacząco redukują halucynacje, ale ich nie eliminują, a ważne informacje trzeba weryfikować [14]. Zaplanuj proces ze sprawdzaniem zamiast liczyć na idealny model.
5. Znane prawdziwe przypadki
Prawnicy i zmyślone sprawy (USA, 2023). W sprawie Mata v. Avianca prawnik użył ChatGPT do znalezienia precedensów sądowych i złożył pismo z sprawami, które nie istnieją. 22 czerwca 2023 sędzia Castel nakazał dwóm prawnikom i ich kancelarii zapłacić grzywnę 5000 dolarów oraz powiadomić sędziów, których nazwiska figurowały jako autorzy zmyślonych orzeczeń. Sąd uznał, że prawnicy działali w złej wierze: gdy problem wyszedł na jaw, nadal bronili zmyślonych spraw [12]. Lekcja nie leży w samym błędzie, tylko w tym, że odpowiedzi nie sprawdzono, a potem jej broniono.
Chatbot linii lotniczej (Kanada, 2024). Chatbot Air Canada poinformował pasażera, że zniżkę żałobną na bilet można uzyskać już po podróży. Rzeczywiste zasady na to nie pozwalały. W lutym 2024 trybunał w Kolumbii Brytyjskiej uznał linię lotniczą za odpowiedzialną za to, co powiedział jej chatbot. Spór dotyczył niewielkiej kwoty (około 880 dolarów kanadyjskich), ale decyzja stała się przykładem: firma odpowiada za odpowiedzi swojego bota [13]. Szczegóły pochodzą ze źródła wtórnego; link do samej decyzji jest na liście.
Usługi prawnicze AI. Badanie ze Stanford (patrz wyżej) pokazało, że nawet płatne profesjonalne narzędzia z przeszukiwaniem bazy mylą się wyraźnie częściej, niż obiecują sprzedawcy [10].
6. Jak ograniczyć ryzyko
Wszystkie techniki mają jedną wspólną ideę: nie proś modelu o przypomnienie sobie, tylko daj mu materiał i wymagaj, żeby oparł się na tym materiale. Podejście, w którym model najpierw wyszukuje potrzebne dokumenty, a potem odpowiada, nazywa się w literaturze RAG (retrieval plus generation, czyli wyszukiwanie plus generowanie). Pojawiło się w pracy Lewisa i współautorów (2020), gdzie ten schemat dał dokładniejsze i bardziej faktograficzne teksty niż model bez wyszukiwania [15]. RAG nie likwiduje błędów: w badaniu prawniczym [10] narzędzia z wyszukiwaniem też się myliły, a w badaniu stomatologicznym [9] systemy z wyszukiwaniem nie zmyślały odniesień, ale źle interpretowały to, co znalazły.
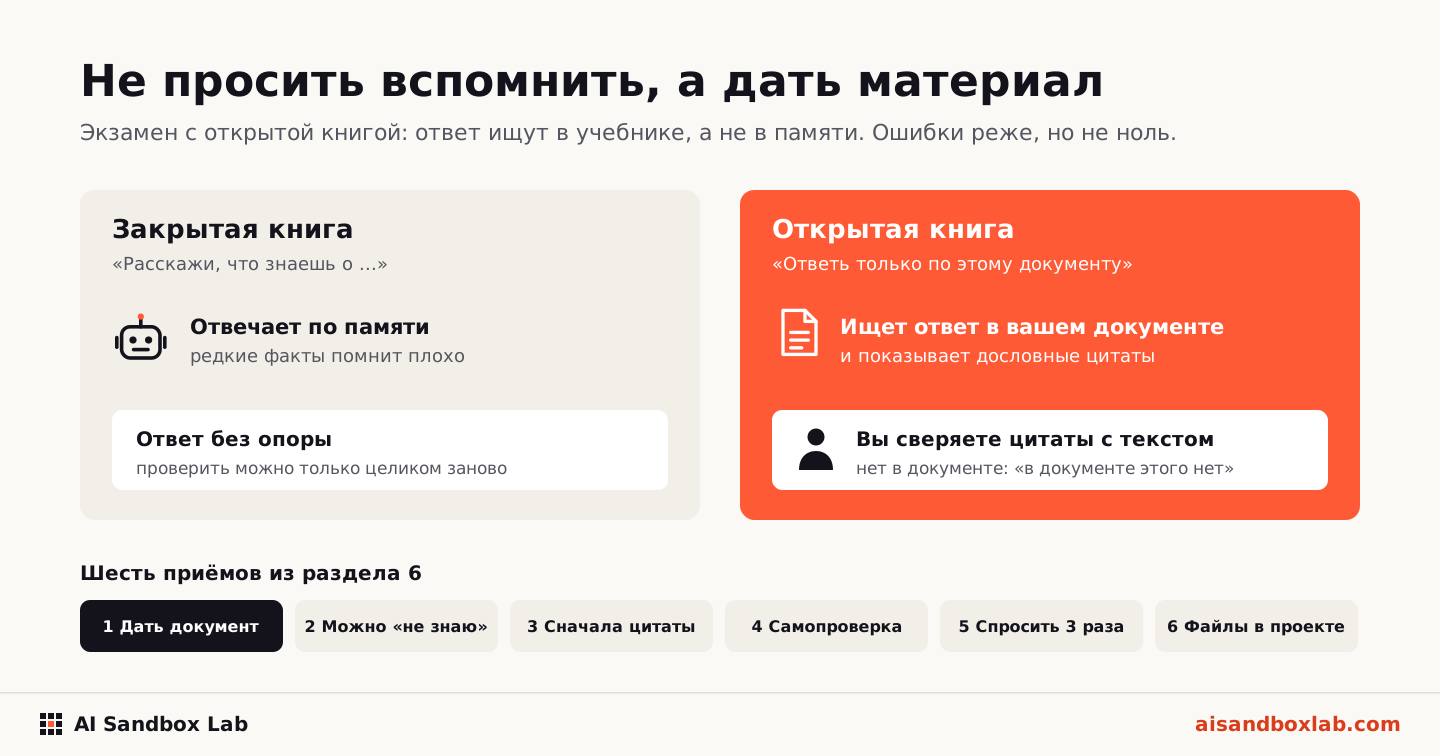
Praktyka Technika 1. Podaj dokument i ogranicz źródło
Zalecenie z dokumentacji Anthropic: poproś model, żeby korzystał tylko z podanych dokumentów, a nie z wiedzy ogólnej [14].
Answer using only the document below. Do not use general knowledge.
If the document does not contain the answer, write: "The document does not say".
<document>
(paste the text)
</document>
Question: (your question)
Praktyka Technika 2. Pozwól mu powiedzieć „nie wiem"
Anthropic pisze, że wyraźne zezwolenie na przyznanie się do niepewności może znacząco zmniejszyć liczbę fałszywych stwierdzeń [14]. To wiąże się też z przyczyną z sekcji 2: domyślnie model czuje się zobowiązany do odpowiedzi.
If you are not sure of an answer or lack data, say so:
"Not sure" or "Not enough data". Do not make things up.
List separately what you know for certain in the answer and what you are assuming.
Praktyka Technika 3. Najpierw cytaty, potem wnioski
Przy długich dokumentach Anthropic radzi najpierw poprosić o dosłowne cytaty i wyciągać wnioski wyłącznie z nich [14].
First pull out word-for-word quotes from the document that relate to the question, with numbers.
If there are no suitable quotes, write "No quotes found".
Then draw a conclusion, referring to the quote numbers. Add nothing beyond the quotes.
Praktyka Technika 4. Pozwól modelowi sprawdzić własną wersję roboczą
Metoda Chain-of-Verification (Dhuliawala i współautorzy, 2023): model pisze wersję roboczą, formułuje pytania weryfikacyjne, odpowiada na nie osobno od wersji roboczej i tworzy poprawioną wersję końcową. Autorzy podają, że w kilku testach ograniczyła halucynacje [16]. To preprint, a nie artykuł po recenzji. Poniżej uproszczona wersja do czatu.
You wrote the answer above. Now:
1. List all verifiable claims (figures, dates, names, links).
2. For each, formulate a check question and answer it without looking at the draft.
3. Compare. Remove or flag whatever was not confirmed.
4. Give the corrected answer.
Zastrzeżenie: model sprawdza sam siebie, więc nie zawsze to pomaga. Najważniejsze sprawdzenia (liczby, linki, fakty prawne i finansowe) wykonaj względem źródła pierwotnego.
Praktyka Technika 5. Zadaj pytanie kilka razy
Pomysł pochodzi z metody SelfCheckGPT: jeśli model zna temat, powtarzane odpowiedzi są zgodne, a zmyślone szczegóły od czasu do czasu się zmieniają [17]. Anthropic zaleca tę samą technikę: uruchom jedno zapytanie kilka razy i porównaj wyniki, bo różnice mogą wskazywać na halucynację [14]. Zadaj jedno pytanie w trzech świeżych czatach. Sprawdź ręcznie wszystko, co się nie zgadza. Zgodność nie dowodzi poprawności: model może konsekwentnie powtarzać ten sam błąd.
Praktyka Technika 6. Dla agentów w IDE: źródło w folderze projektu
Jeśli pracujesz z agentem (Cursor, Claude Code, Antigravity), umieść potrzebne dokumenty w folderze projektu i dopisz tę regułę do plików z zasadami (CLAUDE.md lub AGENTS.md):
Treat as facts only what is in the project files.
If a fact is not in the files, write "needs clarification" instead of inventing it.
For every important conclusion, add the file name and a quote.
7. Lista kontrolna: jak sprawdzać odpowiedź modelu
Sprawdzanie nie zawsze jest potrzebne. Im wyższy koszt błędu, tym surowsze sprawdzanie.
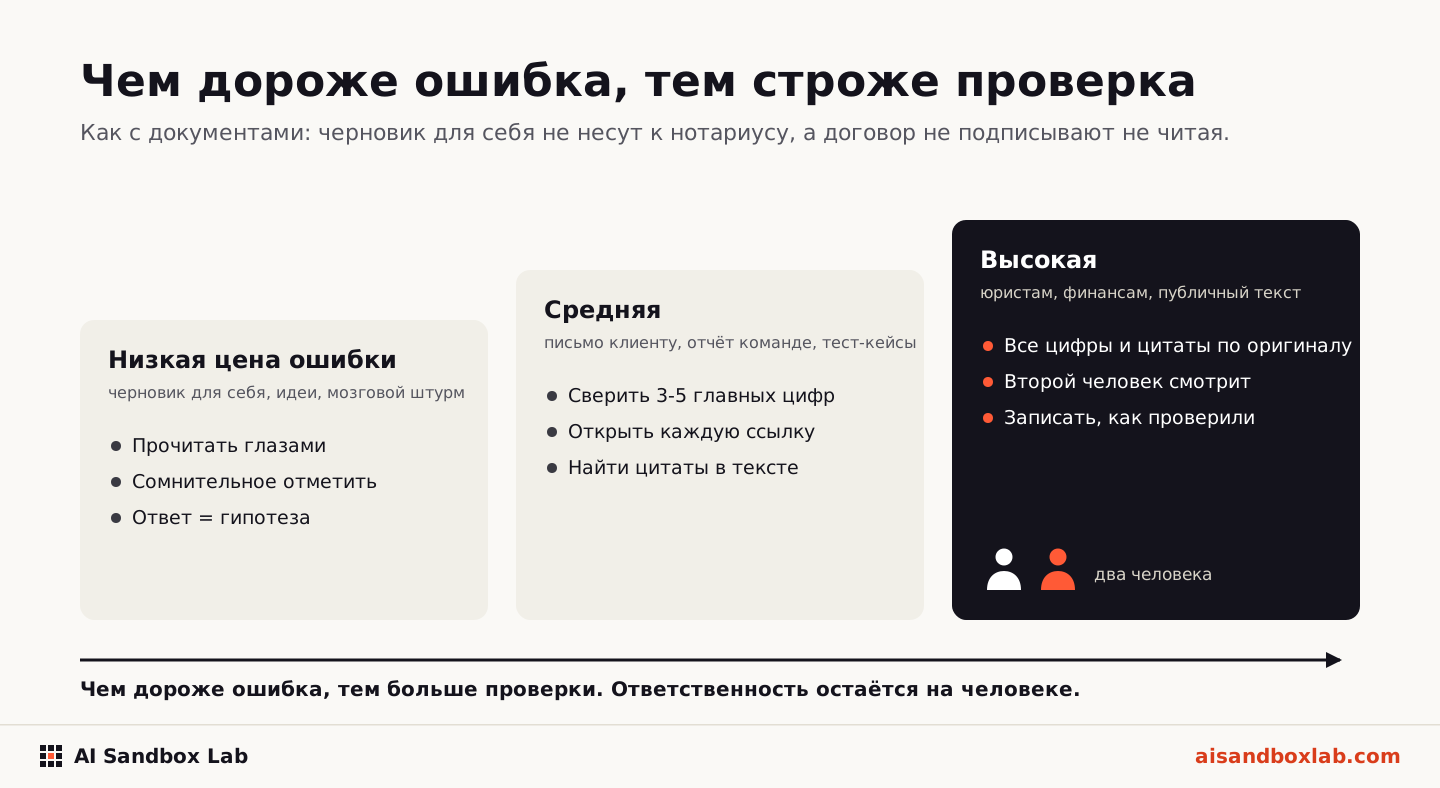
- Koszt błędu. Czy to szkic dla siebie, e-mail do klienta, czy dokument dla prawników i księgowych? Im wyższy koszt, tym więcej sprawdzania.
- Czy jest źródło? Czy poprosiłeś model, żeby oparł się na Twoim dokumencie? Jeśli nie, traktuj odpowiedź jako hipotezę.
- Liczby, daty, nazwiska. Wybierz 3-5 najważniejszych i sprawdź w źródle pierwotnym. Jeśli wszystkie się zgadzają, szansa na błąd jest mniejsza, ale nie zerowa.
- Linki i cytaty. Otwórz każdy link. Upewnij się, że strona istnieje i mówi to, co model jej przypisuje. Prawdziwy tytuł artykułu z zmyślonym wnioskiem to częsty schemat.
- Dosłowne cytaty. Znajdź cytat w dokumencie wyszukiwaniem tekstu (Ctrl+F). Jeśli go tam nie ma, został zmyślony.
- Odpowiedź jest zbyt gładka. Brak zastrzeżeń, brak „nie wiem", idealnie pasuje do Twojego pytania. To powód do ostrożności.
- Powtórz pytanie. Czy odpowiedzi różnią się szczegółami? Sprawdź właśnie te szczegóły.
- Zapytaj „skąd to wiesz?". Poproś model o wskazanie źródła i cytatu. Jeśli nie potrafi, za tym nic nie stoi. Pamiętaj jednak, że model też potrafi wymyślić źródło, więc otwórz je sam.
- Druga osoba. Przy ważnych decyzjach poproś kolegę o spojrzenie na wnioski i źródła.
- Zapisz, jak sprawdzałeś. Jedna linia w dokumencie: „liczby sprawdzone z raportem X, linki otwarte". Wtedy da się powtórzyć kontrolę.
Ważne
Odpowiedzialność za wynik zostaje po stronie człowieka. W obu znanych przypadkach powyżej winę ponieśli nie model, lecz ci, którzy użyli jego odpowiedzi bez sprawdzenia, albo wypuścili bota bez kontroli [12][13].
Co warto zapamiętać
- Halucynacja to nie usterka, tylko skutek tego, jak model jest zbudowany i jak jest oceniany [1][4].
- Wskaźnik zależy od zadania: streszczanie dokumentu daje wartości jednocyfrowe, a pytania o rzadkie fakty i odniesienia do literatury dają dziesiątki procent [6][7][8].
- Nowy model nie gwarantuje mniejszej liczby błędów [6][7].
- Najlepszy sposób na ryzyko: podaj dokument, pozwól na „nie wiem", wymagaj cytatów i sprawdzaj główne tezy ręcznie [14][15].
Załącznik A. Słowniczek
| Termin | Prostymi słowami |
|---|---|
| Model, model językowy | Program, który nauczył się kontynuować tekst na podstawie ogromnej liczby przykładów. ChatGPT, Claude i Gemini działają na takich modelach. |
| Halucynacja | Wiarygodna, pewnie podana odpowiedź, która nie zgadza się z faktami albo z Twoim dokumentem. |
| Prompt | Treść zapytania, które wysyłasz do modelu. |
| Źródło, dokument | Materiał, który dajesz modelowi: protokół, regulamin, raport, tabela. Odpowiedź sprawdza się potem względem niego. |
| Kalibracja | Stopień, w jakim pewność modelu zgadza się z jego rzeczywistą trafnością. Jak prognoza pogody: jeśli „70% szans na deszcz" sprawdza się w 7 przypadkach na 10, prognoza jest skalibrowana. |
| Benchmark | Standardowy zestaw pytań do porównywania modeli. Jak wspólny egzamin dla wszystkich. |
| RAG (wyszukiwanie plus generowanie) | Schemat, w którym model najpierw znajduje potrzebne dokumenty, a potem odpowiada na ich podstawie. Egzamin z otwartą książką. |
| Chain-of-Verification | Technika samosprawdzania: wersja robocza, pytania weryfikacyjne, odpowiedzi na nie, poprawiona wersja końcowa (sekcja 6, technika 4). |
| SelfCheckGPT | Sposób wykrywania zmyśleń przez niespójności: to samo pytanie zadaje się kilka razy i porównuje odpowiedzi (sekcja 6, technika 5). |
| Karta systemowa (system card) | Raport producenta modelu o jego możliwościach, testach i ryzykach. Pisany przez samego dostawcę. |
| Preprint | Artykuł naukowy opublikowany przed recenzją przez innych naukowców. Użyteczny, ale mniej dokładnie sprawdzony niż artykuł w czasopiśmie. |
| Agent | Model, który nie tylko odpowiada w czacie, ale sam wykonuje kroki: czyta pliki, szuka, edytuje dokumenty. |
| CLAUDE.md, AGENTS.md | Plik z zasadami projektu, który agent czyta na początku pracy. Dobre miejsce na regułę „fakty tylko z plików". |
Załącznik B. Źródła
Linki sprawdzone 2 listopada 2026.
- Kalai A. T., Nachum O., Vempala S. S., Zhang E. Why Language Models Hallucinate. 2025. arXiv:2509.04664 (preprint). https://arxiv.org/abs/2509.04664
- Ji Z., Lee N., Frieske R. et al. Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, vol. 55, no. 12, 2023. https://doi.org/10.1145/3571730 (preprint: https://arxiv.org/abs/2202.03629)
- Huang L., Yu W., Ma W. et al. A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions. ACM Transactions on Information Systems, 2024/2025. https://doi.org/10.1145/3703155 (preprint: https://arxiv.org/abs/2311.05232)
- Kalai A. T., Vempala S. S. Calibrated Language Models Must Hallucinate. STOC 2024 (preprint 2023). https://arxiv.org/abs/2311.14648
- Wei J., Karina N., Chung H. W. et al. Measuring short-form factuality in large language models (SimpleQA). OpenAI, 2024. arXiv:2411.04368 (preprint). https://arxiv.org/abs/2411.04368
- Vectara. Hallucination Leaderboard (HHEM). A live leaderboard, last updated 22.10.2026 at the time of checking. https://github.com/vectara/hallucination-leaderboard
- OpenAI. OpenAI o3 and o4-mini System Card. April 16, 2025. https://cdn.openai.com/pdf/2221c875-02dc-4789-800b-e7758f3722c1/o3-and-o4-mini-system-card.pdf
- Walters W. H., Wilder E. I. Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045, 2023. https://doi.org/10.1038/s41598-023-41032-5
- Hooshiar M. H. Artificial intelligence reliability in implant dentistry: a comparative analysis of clinical accuracy and hallucination patterns across multiple language models. Journal of Prosthetic Dentistry, 135(5), e155-e161, 2025. https://doi.org/10.1016/j.prosdent.2025.11.005 (per PubMed, abstract only)
- Magesh V., Surani F., Dahl M., Suzgun M., Manning C. D., Ho D. E. Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. 2024. arXiv:2405.20362 (preprint). https://arxiv.org/abs/2405.20362
- Xu Z., Jain S., Kankanhalli M. Hallucination is Inevitable: An Innate Limitation of Large Language Models. 2024. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
- Mata v. Avianca, Inc., No. 22-cv-1461, S.D.N.Y., sanctions decision of 22.06.2023 (Judge P. K. Castel). Summary: ABA Journal, "Lawyers who doubled down and defended ChatGPT's fake cases must pay $5K, judge says". https://abajournal.com/web/article/lawyers-who-doubled-down-and-defended-chatgpts-fake-cases-must-pay-5k-judge-says
- Moffatt v. Air Canada, 2024 BCCRT 149, Civil Resolution Tribunal of British Columbia, 14.02.2024. Decision: https://decisions.civilresolutionbc.ca/crt/crtd/en/525448/1/document.do (the text itself could not be opened automatically; details from a secondary source: https://en.wikipedia.org/wiki/Moffatt_v._Air_Canada)
- Anthropic. Reduce hallucinations (Claude documentation). https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations
- Lewis P., Perez E., Piktus A. et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Dhuliawala S., Komeili M., Xu J. et al. Chain-of-Verification Reduces Hallucination in Large Language Models. 2023. arXiv:2309.11495 (preprint). https://arxiv.org/abs/2309.11495
- Manakul P., Liusie A., Gales M. J. F. SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models. EMNLP 2023. https://arxiv.org/abs/2303.08896
Naucz się tego, robiąc
W grupach praktycznych AI Sandbox Lab pracujesz z agentem nad własnymi zadaniami, zamiast tylko czytać o tym. Nie trzeba programować.
Читать по-русски · Read in English · Чытаць па-беларуску