Памятка AI Sandbox Lab для ўдзельнікаў практычных груп.
- Для каго: Product Manager, Project Manager, бізнес-аналітык, QA, Engineering Manager і ўсе, хто працуе з AI без досведу праграмавання
- Час чытання: каля 15 хвілін
- Крыніцы: даследаванні і дакументацыя, спасылкі правераны 2 лістапада 2026 года; нумары ў квадратных дужках вядуць да спісу ў канцы
Карта памяткі
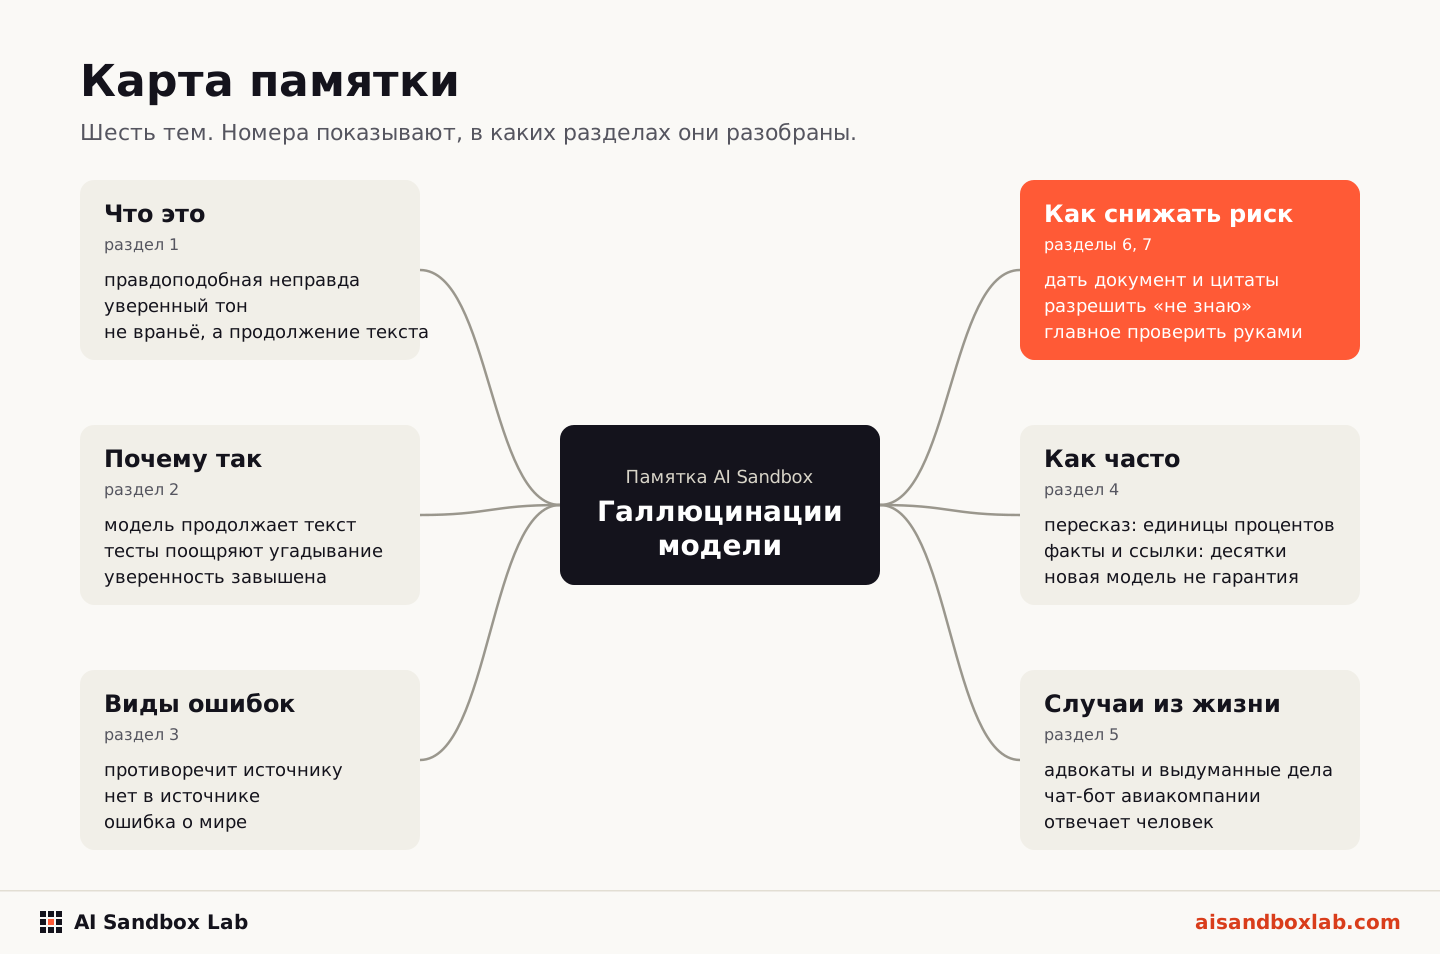
Адразу галоўнае: гладкі тэкст не роўны факту
Мадэль часам выдае праўдападобную няпраўду: дакладную лічбу, якой няма, спасылку на артыкул, якога няма, цытату, якую ніхто не казаў. Гэта не паломка канкрэтнага сервісу, а вынік таго, як мадэлі ўладкаваны і як іх вучаць. Прыбраць гэта цалкам нельга, але рызыку можна моцна знізіць: даць мадэлі ваш дакумент, дазволіць ёй сказаць "не ведаю", патрабаваць цытаты і правяраць галоўнае ўручную. Чым даражэй памылка, тым строгшая праверка.
1. Што такое галюцынацыя
Галюцынацыя мадэлі - гэта праўдападобны, упэўнены адказ, які не адпавядае рэальнасці або зыходным даным. Даследчыкі апісваюць яе падобным чынам: мадэль выдае "праўдападобны, але нефактычны" тэкст [3].
Слова не зусім удалае. У чалавека галюцынацыя - гэта ўспрыманне таго, чаго няма. У мадэлі няма ні ўспрымання, ні намеру схлусіць. Аўтары адной з ключавых прац наўпрост адзначаюць, што гэта з'ява "прынцыпова адрозніваецца" ад чалавечага досведу [1]. Таму далей мы будзем гаварыць прасцей: мадэль выдала праўдападобную няпраўду.
Карысна Бытавая аналогія: выдатнік ля дошкі
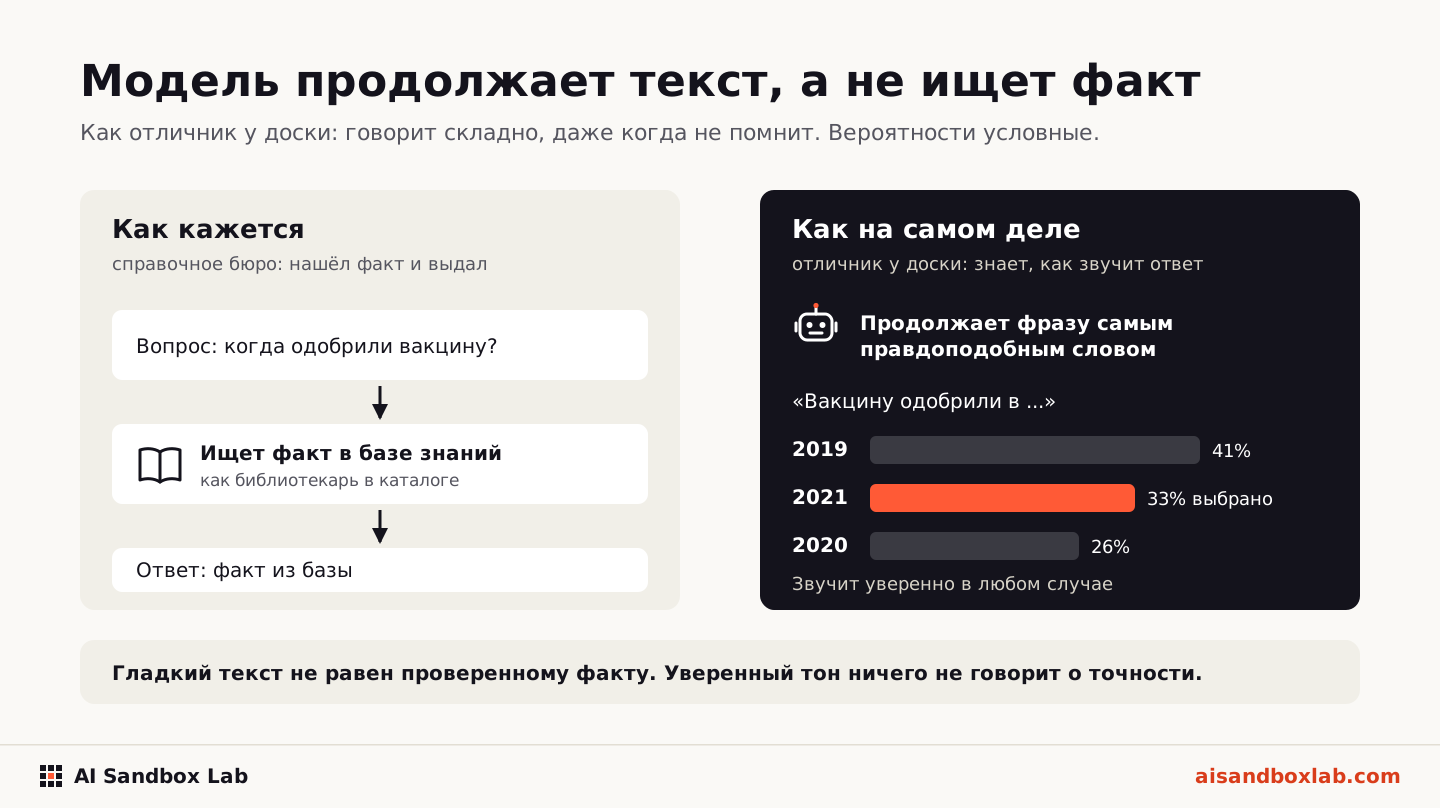
Уявіце студэнта, які вывучыў, як гучаць правільныя адказы, але не памятае фактаў. Яго выклікалі да дошкі, і ён ведае: маўчаць нельга, адзнака за пусты адказ горшая, чым за спробу. Ён гаворыць складна, упэўненым тонам, у патрэбнай тэрміналогіі. Часам трапляе, часам не, а па інтанацыі адрозніць немагчыма. Мадэль уладкавана падобна: яна працягвае тэкст так, як ён звычайна гучыць, а не звяраецца з базай фактаў.
2. Чаму мадэль так робіць
Коратка, тры прычыны.
1. Мадэль вучыцца прадказваць тэкст, а не захоўваць факты. Яна бачыла вялізную колькасць тэкстаў і навучылася працягваць іх праўдападобна. Калі факт сустракаўся ў навучанні рэдка або адзін раз, мадэль ведае яго дрэнна. Тэарэтычная праца Калая і Вемпалы паказвае: нават пры ідэальных навучальных даных доля памылак на такіх рэдкіх фактах прыкладна роўная долі фактаў, якія сустрэліся ў навучанні роўна адзін раз [4]. Гэта матэматычны вынік для ідэалізаванай мадэлі, а не наўпроставае вымярэнне на канкрэтным прадукце.
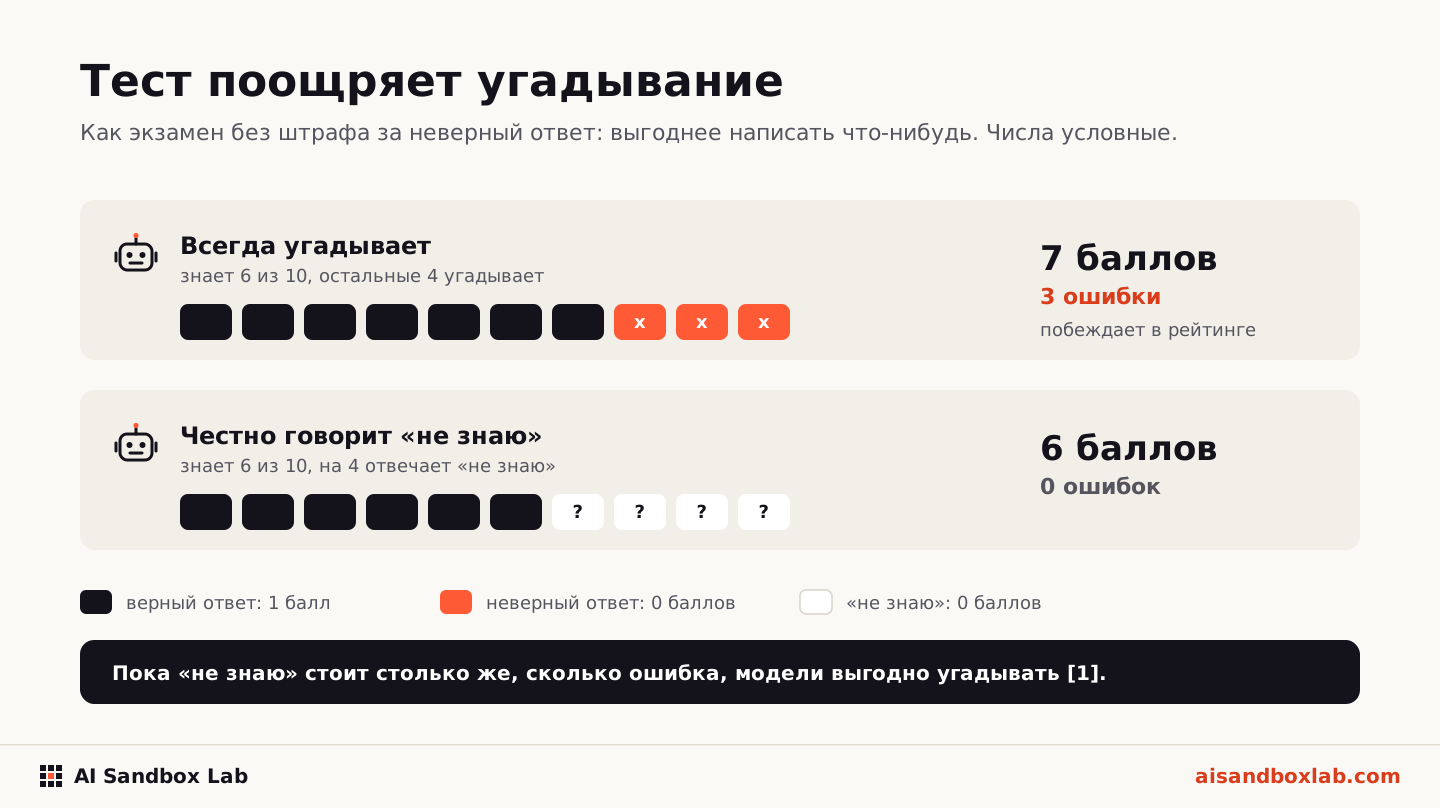
2. Навучанне і ацэнкі заахвочваюць адгадванне. Гэта галоўны вывад свежай працы даследчыкаў OpenAI "Чаму моўныя мадэлі галюцынуюць" (2025). Большасць тэстаў, на якіх параўноўваюць мадэлі, ставяць 1 бал за правільны адказ і 0 за адказ "не ведаю". Тады мадэль, якая заўсёды адгадвае, набірае больш балаў, чым мадэль, якая сумленна прызнаецца ў няведанні. Аўтары пішуць, што навучанне і ацэнка "заахвочваюць адгадванне, а не прызнанне нявызначанасці" [1]. Як студэнт на экзамене без штрафаў за няправільны адказ: выгадна пісаць што-небудзь.
3. Мадэль дрэнна ацэньвае ўласную ўпэўненасць. У тэсце SimpleQA (4 326 кароткіх фактычных пытанняў) аўтары прасілі мадэль назваць сваю ўпэўненасць у адказе. Вывад: упэўненасць мадэлі звязана з дакладнасцю, але мадэлі "паслядоўна завышаюць" яе [5].
Карысна Два словы, якія сустракаюцца ў даследаваннях
Каліброўка - наколькі ўпэўненасць адказу супадае з рэальнай дакладнасцю. Добра адкалібраваная мадэль, кажучы "я на 70% упэўнена", мае рацыю прыкладна ў 70% выпадкаў. Бенчмарк - стандартны набор пытанняў, на якім параўноўваюць мадэлі, як экзамен.
3. Віды галюцынацый
У навуковых аглядах часцей за ўсё выкарыстоўваюць два падзелы.
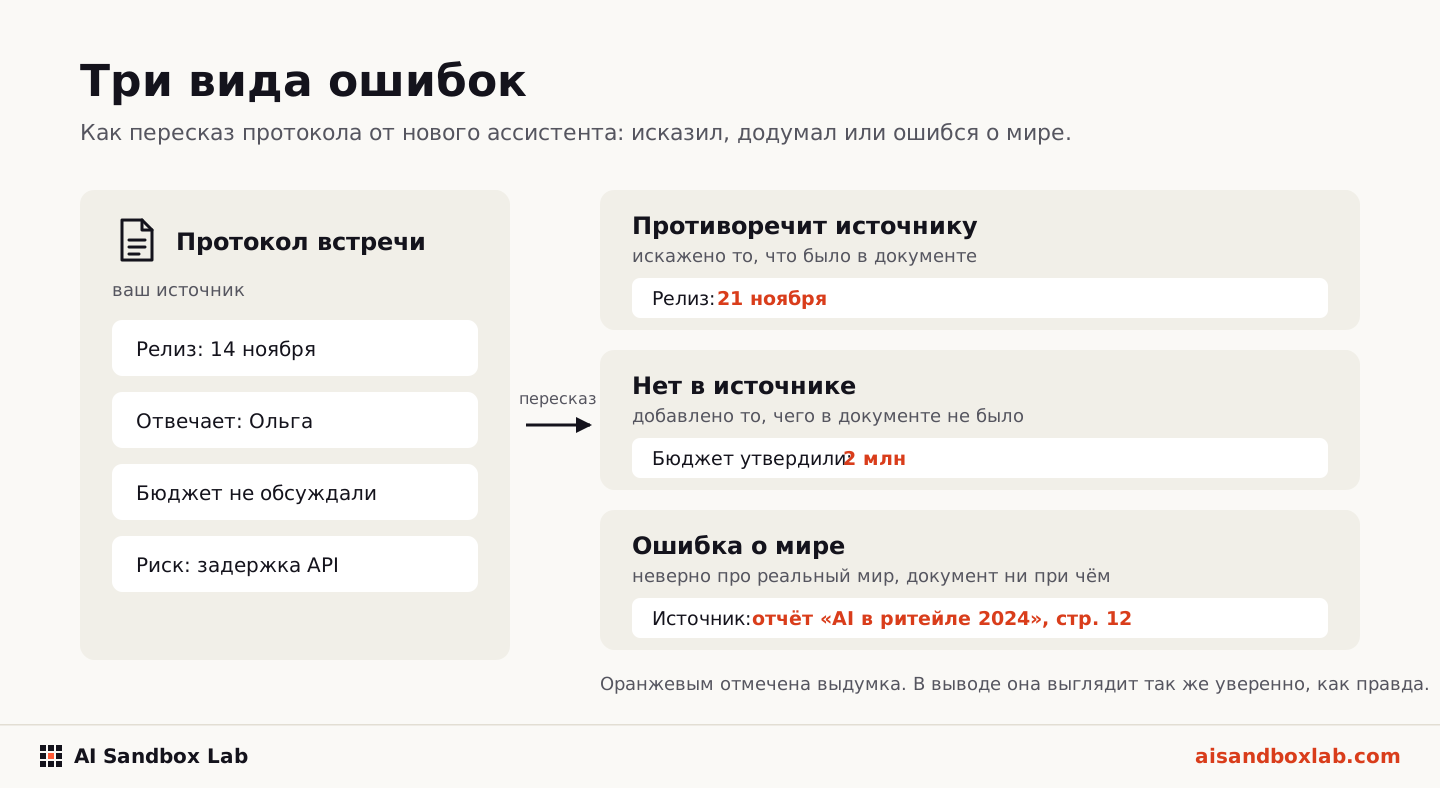
Першае: па адносінах да таго, што вы далі мадэлі. Гэта класіфікацыя з агляду Ji і суаўтараў [2].
- Супярэчыць вашай крыніцы. Вы далі дакумент, а мадэль у пераказе скажала яго. У аглядзе прыклад: у тэксце вакцына ўхвалена ў 2019 годзе, а ў пераказе стаіць 2021.
- Нельга праверыць па вашай крыніцы. Мадэль дадала тое, чаго ў дакуменце няма. Аўтары адзначаюць, што такое даданне не заўсёды памылковае, але патрабуе асцярожнасці, бо праверыць яго па крыніцы нельга.
Другое: памылка пра свет або памылка пра вашу задачу. Агляд Huang і суаўтараў дзеліць галюцынацыі на фактычныя (разыходзяцца з рэальнымі фактамі) і на "вернасць" (разыходзяцца з вашым уводам або інструкцыяй) [3].
Як гэта выглядае ў працы:
| Роля | Прыклад | Від |
|---|---|---|
| Product Manager | Просіце сцісла выкласці 20 інтэрв'ю з кліентамі. У зводцы з'яўляецца цытата, якую ніхто не казаў | не з крыніцы |
| Product Manager | Просіце даныя пра памер рынку. Атрымліваеце дакладную лічбу са спасылкай на справаздачу, якой не існуе | фактычная памылка |
| Project Manager | Просіце пераказаць пратакол сустрэчы. Тэрмін у пераказе зрушыўся, адказны ўказаны няправільна | супярэчыць крыніцы |
| Бізнес-аналітык | Просіце выпісаць патрабаванні з рэгламенту. З'яўляецца пункт, якога ў рэгламенце няма | не з крыніцы |
| QA | Просіце тэст-кейсы па апісанні функцыі. Частка кейсаў правярае паводзіны, якія ніхто не абяцаў | не з крыніцы |
| Engineering Manager | Просіце спасылкі на артыкулы пра практыкі ацэнкі каманд. Частка назваў і аўтараў прыдумана | фактычная памылка |
Важна
Самы небяспечны варыянт - не абсурдны адказ, а праўдападобны: правільны фармат, упэўнены тон, рэальныя імёны побач з прыдуманымі дэталямі. У даследаванні прыдуманых бібліяграфічных спасылак частка спасылак на рэальныя працы мела істотныя памылкі ў даных (43% у GPT-3.5 і 24% у GPT-4), гэта значыць сумесь сапраўднага і ілжывага [8].
4. Наколькі гэта часта
Адзінай лічбы "мадэль хлусіць у N% выпадкаў" не існуе. Частата залежыць ад задачы, мадэлі, спосабу праверкі і даты. Ніжэй прыклады вымярэнняў. Іх нельга ўсерэдняць і параўноўваць паміж сабой, у іх розныя задачы.
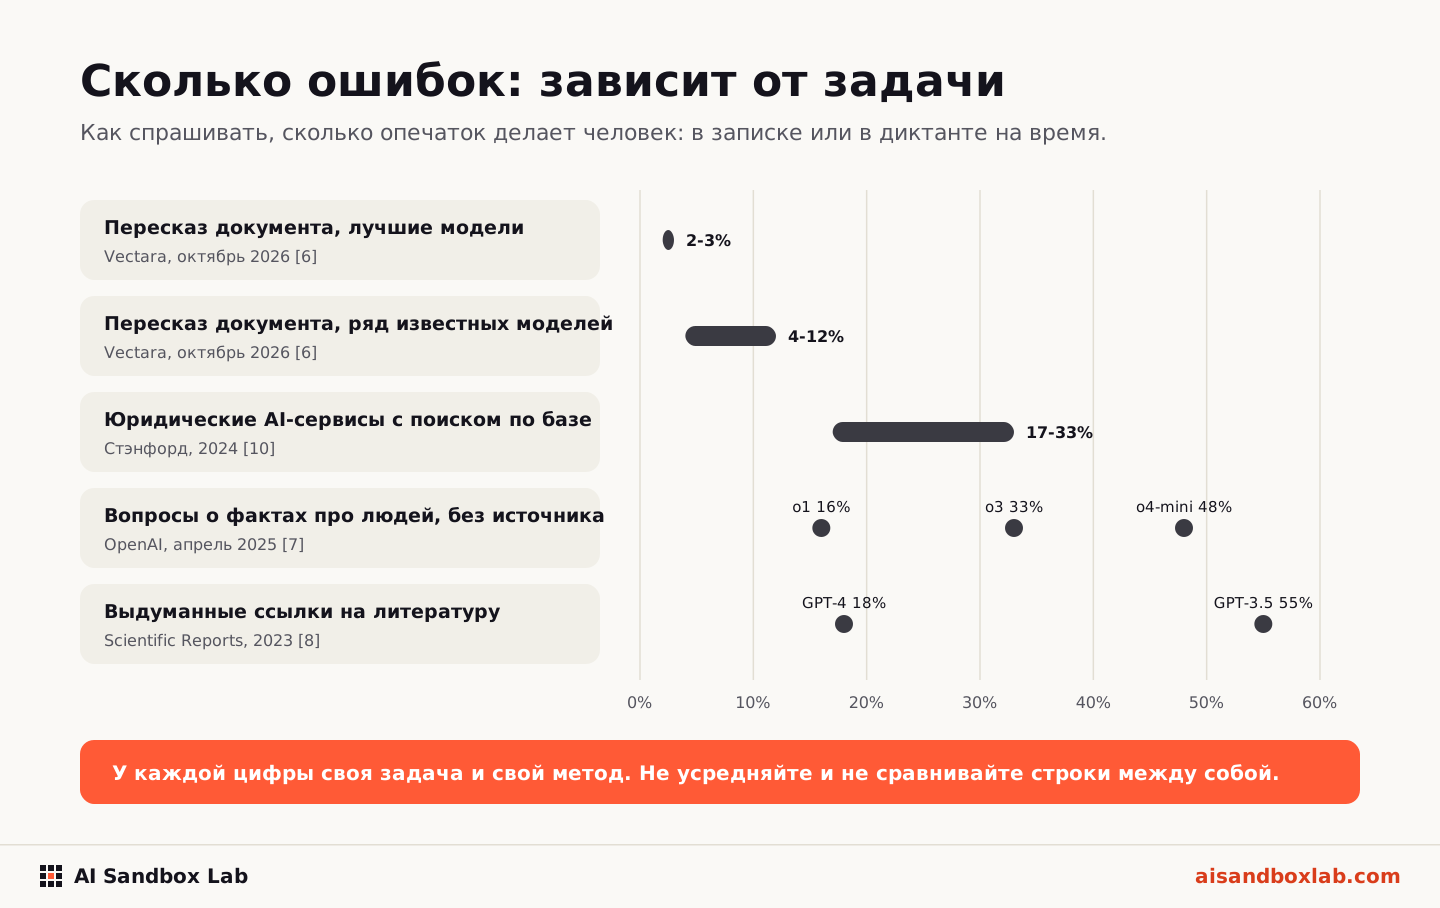
Пераказ дакумента (самая мяккая ўмова). Рэйтынг кампаніі Vectara вымярае, як часта мадэль дадае ў кароткі пераказ дакумента тое, чаго ў ім няма. На 22 кастрычніка 2026 года ў табліцы ў лепшых мадэляў каля 2-3%, у шэрагу вядомых мадэляў 4-12%, у адной з мадэляў лінейкі GPT-5 15,1% [6]. Агаворкі: гэта толькі пераказ кароткіх тэкстаў, набор дакументаў закрыты, ацэнку ставіць іншая мадэль, а не чалавек.
Пытанні пра факты без крыніцы. На тэсце PersonQA (пытанні пра публічныя факты пра людзей) мадэль o3 ад OpenAI па даных распрацоўшчыка памылялася ў 33% адказаў, o4-mini у 48%, папярэдняя o1 у 16% [7]. Дата справаздачы: красавік 2025. Гэта ўнутраны тэст вендара.
Спасылкі на літаратуру. У працы Walters і Wilder (2023) ChatGPT пісаў кароткія агляды па 42 тэмах, усяго 636 спасылак. Прыдуманымі аказаліся 55% спасылак у GPT-3.5 і 18% у GPT-4 [8]. Свежае невялікае даследаванне па стаматалогіі (15 пытанняў, 2025) знайшло высокую долю прыдуманых спасылак у GPT-4o, а ў сістэм, якія шукаюць па рэальных публікацыях, прыдуманых спасылак не было, але былі памылкі ў трактоўцы [9]. Выбарка малая, як ілюстрацыя, а не як ацэнка.
Спецыялізаваныя юрыдычныя AI-інструменты. Каманда Стэнфарда праверыла камерцыйныя сэрвісы юрыдычнага пошуку, якія прадаюцца як "без галюцынацый". Яны памыляліся ў 17-33% запытаў [10]. Праца 2024 года, версіі прадуктаў з тых часоў мяняліся.
Важная агаворка для высноў. Новыя мадэлі не абавязкова галюцынуюць менш. У сістэмнай карце OpenAI сказана, што o3 робіць больш сцвярджэнняў, таму і правільных, і няправільных у яго больш, а прычыну даследчыкі пакуль не ведаюць [7]. У рэйтынгу Vectara у gpt-5-high доля 15,1%, у gpt-4o 9,6%, гэта значыць больш новая мадэль аказалася горшай на гэтай канкрэтнай задачы [6]. Версіі і даты ў мадэляў розныя, таму гэта назіранне, а не закон. Вывад: "мадэль свежая і разумная" не замяняе праверку.
Карысна Ці можна давесці да нуля
Паводле тэарэтычнай працы Xu і суаўтараў, цалкам ліквідаваць галюцынацыі ў моўных мадэляў немагчыма [11]. Гэта матэматычнае сцвярджэнне пры пэўных дапушчэннях, але практычны вывад супадае з рэкамендацыяй Anthropic у яе дакументацыі: прыёмы значна зніжаюць галюцынацыі, але не ліквідуюць іх цалкам, а важную інфармацыю трэба правяраць [14]. Плануйце працэс з праверкай, а не спадзявайцеся на ідэальную мадэль.
5. Гучныя выпадкі з рэальнасці
Адвакаты і прыдуманыя справы (ЗША, 2023). У справе Mata v. Avianca адвакат выкарыстаў ChatGPT для пошуку судовых прэцэдэнтаў і падаў у суд дакумент з неіснуючымі справамі. Суддзя Кастэл 22 чэрвеня 2023 года абавязаў двух адвакатаў і іх фірму заплаціць 5 000 долараў штрафу, а таксама паведаміць суддзям, чые імёны былі пазначаны як аўтары выдуманых рашэнняў. Суд палічыў, што адвакаты дзейнічалі несумленна: пасля выяўлення праблемы яны адстойвалі прыдуманыя справы [12]. Урок не ў самой памылцы, а ў тым, што адказ не праверылі і потым абаранялі.
Чат-бот авіякампаніі (Канада, 2024). Чат-бот Air Canada паведаміў пасажыру, што зніжку на білет у сувязі са стратай блізкага можна аформіць пасля паездкі. Рэальныя правілы гэтага не дазвалялі. У лютым 2024 года трыбунал Брытанскай Калумбіі прызнаў авіякампанію адказнай за словы яе чат-бота. Сума спрэчкі была невялікай (каля 880 канадскіх долараў), але рашэнне стала прыкладам: кампанія адказвае за адказы свайго бота [13]. Дэталі ўзяты з другаснай крыніцы, спасылка на само рашэнне ёсць у спісе.
Юрыдычныя AI-сэрвісы. Даследаванне Стэнфарда (гл. вышэй) паказала, што нават платныя прафесійныя інструменты з пошукам па базе памыляюцца прыкметна часцей, чым абяцаюць прадаўцы [10].
6. Як знізіць рызыку
Ідэя ўсіх прыёмаў адна: не прасіць мадэль успамінаць, а даваць ёй матэрыял і патрабаваць абапірацца на яго. Падыход, дзе мадэль спачатку дастае патрэбныя дакументы, а потым адказвае, у навуцы называецца RAG (пошук + генерацыя) і з'явіўся ў працы Lewis і суаўтараў (2020), дзе такая схема дала больш дакладныя і фактычныя тэксты, чым мадэль без пошуку [15]. RAG не адмяняе памылак: у юрыдычным даследаванні [10] інструменты з пошукам усё роўна памыляліся, а ў стаматалагічным [9] сістэмы з пошукам не прыдумлялі спасылак, але няправільна трактавалі знойдзенае.
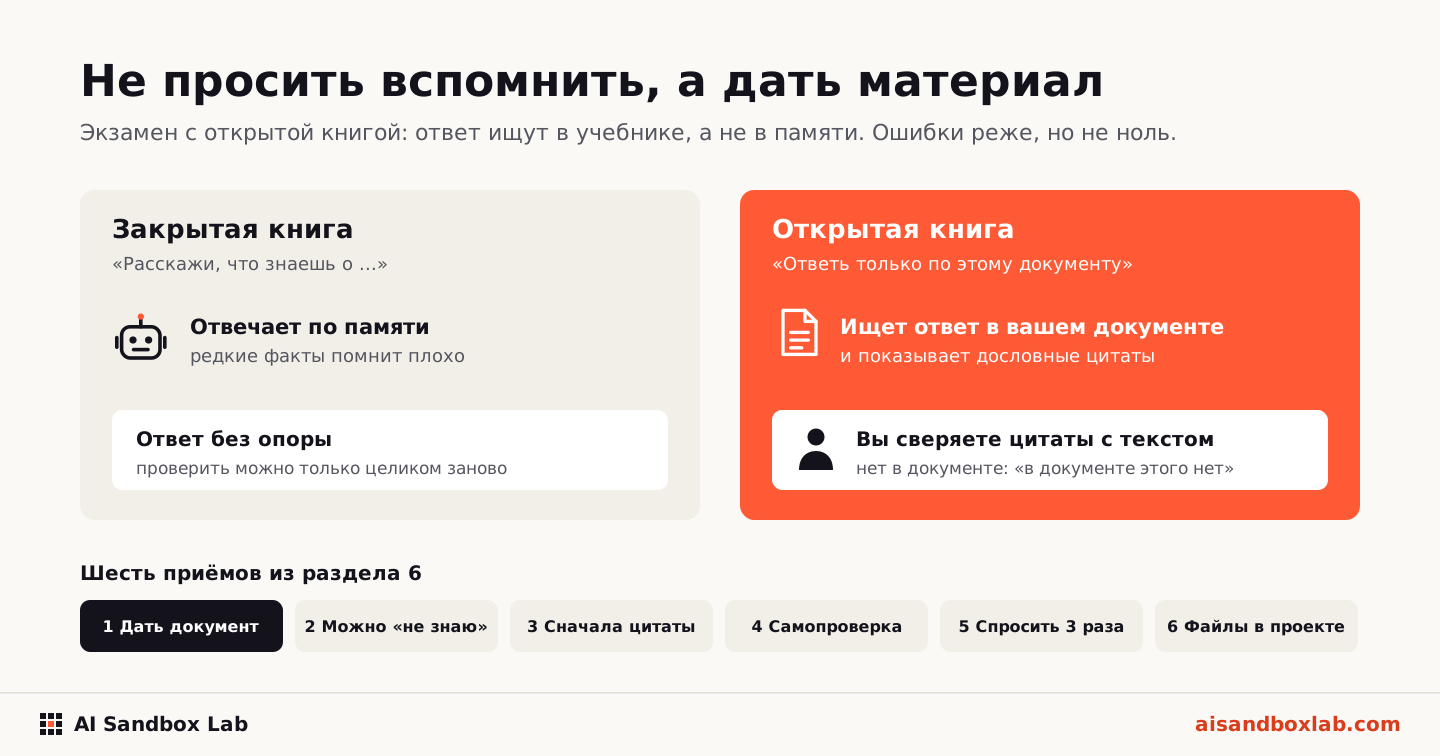
Практыка Прыём 1. Дайце дакумент і абмяжуйце крыніцу
Рэкамендацыя з дакументацыі Anthropic: папрасіць выкарыстоўваць толькі прадастаўленыя дакументы, а не агульныя веды [14].
Адказвай толькі на аснове дакумента ніжэй. Не выкарыстоўвай агульныя веды.
Калі ў дакуменце няма адказу, напішы: "У дакуменце гэтага няма".
<дакумент>
(устаўце тэкст)
</дакумент>
Пытанне: (ваша пытанне)
Практыка Прыём 2. Дазвольце сказаць "не ведаю"
Anthropic піша, што яўны дазвол прызнаць няўпэўненасць можа рэзка знізіць колькасць ілжывых сцвярджэнняў [14]. Гэта звязана і з прычынай з раздзела 2: па змаўчанні мадэль адчувае сябе абавязанай адказаць.
Калі не ўпэўнены ў адказе або не хапае даных, так і скажы:
"Не ўпэўнены" або "Не хапае даных". Не дадумвай.
Асобна пералічы, што ў адказе ты ведаеш дакладна, а што мяркуеш.
Практыка Прыём 3. Спачатку цытаты, потым высновы
Для доўгіх дакументаў Anthropic раіць спачатку папрасіць дакладныя цытаты, а высновы рабіць толькі па іх [14].
Спачатку выпішы дакладныя цытаты з дакумента, якія адносяцца да пытання, з нумарамі.
Калі прыдатных цытат няма, напішы "Цытат не знойдзена".
Затым зрабі выснову, спасылаючыся на нумары цытат. Нічога звыш цытат не дадавай.
Практыка Прыём 4. Хай мадэль сама праверыць чарнавік
Метад Chain-of-Verification (Dhuliawala і суаўтары, 2023): мадэль піша чарнавік, фармулюе правяральныя пытанні, адказвае на іх асобна ад чарнавіка і выдае выпраўлены вынік. Аўтары паведамляюць, што гэта зніжае галюцынацыі ў некалькіх тэстах [16]. Гэта прэпрынт, не рэцэнзаваны артыкул. Ніжэй спрошчаная версія для чата.
Ты напісаў адказ вышэй. Цяпер:
1. Выпішы ўсе сцвярджэнні, якія можна праверыць (лічбы, даты, імёны, спасылкі).
2. Для кожнага сфармулюй пытанне для праверкі і адкажы на яго, не гледзячы на чарнавік.
3. Параўнай. Што не пацвердзілася, прыбяры або пазнач.
4. Выдай выпраўлены адказ.
Агаворка: мадэль правярае саму сябе, таму гэта дапамагае не заўсёды. Галоўныя праверкі (лічбы, спасылкі, юрыдычныя і фінансавыя факты) рабіце па першакрыніцы.
Практыка Прыём 5. Задайце пытанне некалькі разоў
Ідэя з метаду SelfCheckGPT: калі мадэль ведае тэму, паўторныя адказы супадаюць, а прыдуманыя дэталі ад разу да разу мяняюцца [17]. Anthropic рэкамендуе той жа прыём: запусціць адзін запыт некалькі разоў і параўнаць, разыходжанні могуць паказваць на галюцынацыю [14]. Задайце адно пытанне ў трох новых чатах. Усё, што не супала, праверце ўручную. Супадзенне не даказвае правату: мадэль можа паслядоўна паўтараць адну і тую ж памылку.
Практыка Прыём 6. Для агентаў у IDE: крыніца ў тэчцы праекта
Калі вы працуеце з агентам (Cursor, Claude Code, Antigravity), пакладзіце патрэбныя дакументы ў тэчку праекта і ў правілы (CLAUDE.md або AGENTS.md) дадайце радок:
Фактамі лічым толькі тое, што ёсць у файлах праекта.
Калі факта няма ў файлах, пішы "трэба ўдакладніць", а не прыдумвай.
Да кожнай важнай высновы дадавай імя файла і цытату.
7. Чэк-ліст: як праверыць адказ мадэлі
Праверка патрэбна не заўсёды. Чым вышэй цана памылкі, тым строгшая праверка.
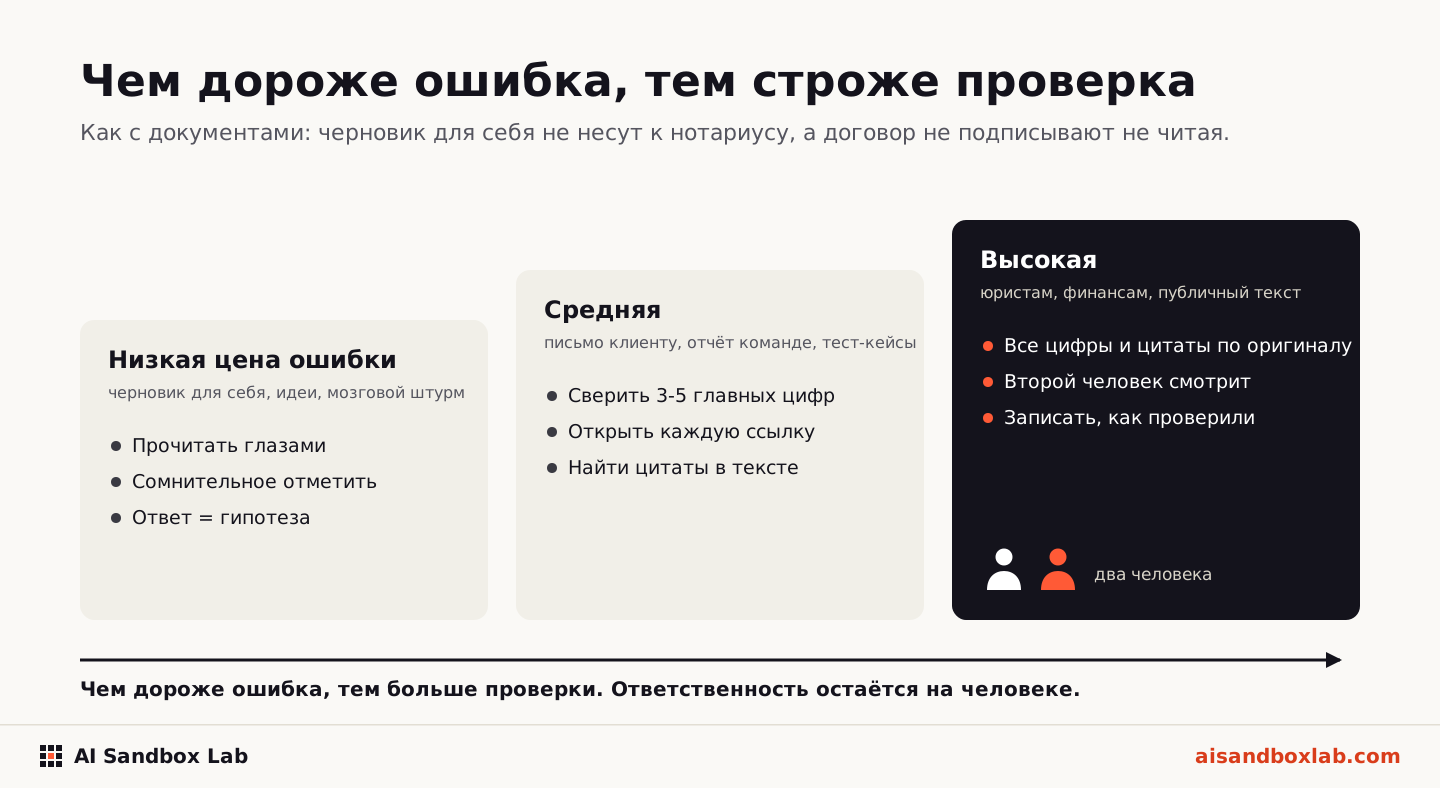
- Цана памылкі. Гэта чарнавік для сябе, ліст кліенту ці дакумент для юрыстаў і бухгалтэрыі? Чым вышэй, тым больш праверкі.
- Ці ёсць крыніца? Ці прасілі вы абапірацца на ваш дакумент? Калі не, лічыце адказ гіпотэзай.
- Лічбы, даты, імёны. Выберыце 3-5 самых важных і звярыце з першакрыніцай. Калі ўсе супалі, шанец на памылку ніжэйшы, але не нулявы.
- Спасылкі і цытаты. Адкрыйце кожную спасылку. Пераканайцеся, што старонка існуе і ў ёй сказана тое, што прыпісвае мадэль. Назва артыкула рэальная, а выснова з яго прыдуманая: часты варыянт.
- Дакладныя цытаты. Знайдзіце цытату ў дакуменце пошукам па тэксце (Ctrl+F). Няма ў дакуменце, значыць прыдумана.
- Адказ занадта гладкі. Няма агаворак, няма "не ведаю", ідэальна пасуе пад ваш запыт. Гэта нагода насцярожыцца.
- Паўтарыце пытанне. Адказы разыходзяцца ў дэталях? Праверце іменна гэтыя дэталі.
- Спытайце "адкуль гэта?" Папрасіце назваць крыніцу і цытату. Не здолела, значыць няма апоры. Але памятайце: мадэль можа выдаць і прыдуманую крыніцу, таму адкрывайце яе самі.
- Другі чалавек. Для важных рашэнняў хай калега паглядзіць высновы і крыніцы.
- Запішыце, як праверылі. Адзін радок у дакуменце: "лічбы звераны са справаздачай X, спасылкі адкрыты". Так вы зможаце паўтарыць праверку.
Важна
Адказнасць за вынік застаецца на чалавеку. У абодвух гучных выпадках вышэй вінаватым прызналі не мадэль, а тых, хто карыстаўся яе адказам без праверкі або выпусціў бота без кантролю [12][13].
Што ўзяць з сабой
- Галюцынацыя - гэта не збой, а вынік таго, як мадэль уладкавана і як яе ацэньваюць [1][4].
- Частата залежыць ад задачы: пераказ дакумента - адзінкі працэнтаў, пытанні пра рэдкія факты і спасылкі на літаратуру - дзясяткі працэнтаў [6][7][8].
- Новая мадэль не гарантуе менш памылак [6][7].
- Найлепшы спосаб знізіць рызыку: даць дакумент, дазволіць "не ведаю", патрабаваць цытаты і правяраць галоўнае ўручную [14][15].
Дадатак А. Слоўнічак
| Тэрмін | Простымі словамі |
|---|---|
| Мадэль, моўная мадэль | Праграма, якая навучылася працягваць тэкст на вялізнай колькасці прыкладаў. ChatGPT, Claude, Gemini працуюць на такіх мадэлях. |
| Галюцынацыя | Праўдападобны і ўпэўнены адказ, які не адпавядае фактам або вашаму дакументу. |
| Промпт | Тэкст запыту, які вы адпраўляеце мадэлі. |
| Крыніца, дакумент | Матэрыял, які вы даеце мадэлі: пратакол, рэгламент, справаздача, табліца. Па ім потым правяраюць адказ. |
| Каліброўка | Наколькі ўпэўненасць мадэлі супадае з яе рэальнай дакладнасцю. Як прагноз надвор'я: калі "70% дажджу" спраўджваецца ў 7 выпадках з 10, прагноз адкалібраваны. |
| Бенчмарк | Стандартны набор пытанняў, на якім параўноўваюць мадэлі. Як адзіны экзамен для ўсіх. |
| RAG (пошук + генерацыя) | Схема, пры якой мадэль спачатку знаходзіць патрэбныя дакументы, а потым адказвае па іх. Экзамен з адкрытай кнігай. |
| Chain-of-Verification | Прыём самаправеркі: чарнавік, правяральныя пытанні, адказы на іх, выпраўлены вынік (раздзел 6, прыём 4). |
| SelfCheckGPT | Спосаб злавіць выдумку па разыходжаннях: адно і тое ж пытанне задаюць некалькі разоў і параўноўваюць адказы (раздзел 6, прыём 5). |
| Сістэмная карта | Справаздача распрацоўшчыка мадэлі пра яе магчымасці, тэсты і рызыкі. Піша сам вендар. |
| Прэпрынт | Навуковы артыкул, выкладзены да рэцэнзіі іншымі вучонымі. Карысны, але правераны слабей за часопісны. |
| Агент | Мадэль, якая не толькі адказвае ў чаце, але і сама выконвае крокі: чытае файлы, шукае, правіць дакументы. |
| CLAUDE.md, AGENTS.md | Файл з правіламі праекта, які агент чытае ў пачатку працы. Туды зручна запісаць правіла "факты толькі з файлаў". |
Дадатак Б. Крыніцы
Дата праверкі спасылак: 2 лістапада 2026 года.
- Kalai A. T., Nachum O., Vempala S. S., Zhang E. Why Language Models Hallucinate. 2025. arXiv:2509.04664 (прэпрынт). https://arxiv.org/abs/2509.04664
- Ji Z., Lee N., Frieske R. і інш. Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, т. 55, вып. 12, 2023. https://doi.org/10.1145/3571730 (прэпрынт: https://arxiv.org/abs/2202.03629)
- Huang L., Yu W., Ma W. і інш. A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions. ACM Transactions on Information Systems, 2024/2025. https://doi.org/10.1145/3703155 (прэпрынт: https://arxiv.org/abs/2311.05232)
- Kalai A. T., Vempala S. S. Calibrated Language Models Must Hallucinate. STOC 2024 (прэпрынт 2023). https://arxiv.org/abs/2311.14648
- Wei J., Karina N., Chung H. W. і інш. Measuring short-form factuality in large language models (SimpleQA). OpenAI, 2024. arXiv:2411.04368 (прэпрынт). https://arxiv.org/abs/2411.04368
- Vectara. Hallucination Leaderboard (HHEM). Жывы рэйтынг, на момант праверкі абноўлены 22.10.2026. https://github.com/vectara/hallucination-leaderboard
- OpenAI. OpenAI o3 and o4-mini System Card. 16 красавіка 2025. https://cdn.openai.com/pdf/2221c875-02dc-4789-800b-e7758f3722c1/o3-and-o4-mini-system-card.pdf
- Walters W. H., Wilder E. I. Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045, 2023. https://doi.org/10.1038/s41598-023-41032-5
- Hooshiar M. H. Artificial intelligence reliability in implant dentistry: a comparative analysis of clinical accuracy and hallucination patterns across multiple language models. Journal of Prosthetic Dentistry, 135(5), e155-e161, 2025. https://doi.org/10.1016/j.prosdent.2025.11.005 (паводле даных PubMed, толькі анатацыя)
- Magesh V., Surani F., Dahl M., Suzgun M., Manning C. D., Ho D. E. Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. 2024. arXiv:2405.20362 (прэпрынт). https://arxiv.org/abs/2405.20362
- Xu Z., Jain S., Kankanhalli M. Hallucination is Inevitable: An Innate Limitation of Large Language Models. 2024. arXiv:2401.11817 (прэпрынт). https://arxiv.org/abs/2401.11817
- Mata v. Avianca, Inc., № 22-cv-1461, S.D.N.Y., рашэнне пра санкцыі ад 22.06.2023 (суддзя П. К. Кастэл). Пераказ: ABA Journal, "Lawyers who doubled down and defended ChatGPT's fake cases must pay $5K, judge says". https://abajournal.com/web/article/lawyers-who-doubled-down-and-defended-chatgpts-fake-cases-must-pay-5k-judge-says
- Moffatt v. Air Canada, 2024 BCCRT 149, Civil Resolution Tribunal of British Columbia, 14.02.2024. Рашэнне: https://decisions.civilresolutionbc.ca/crt/crtd/en/525448/1/document.do (сам тэкст не атрымалася адкрыць аўтаматычна; дэталі па другаснай крыніцы: https://en.wikipedia.org/wiki/Moffatt_v._Air_Canada)
- Anthropic. Reduce hallucinations (дакументацыя Claude). https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations
- Lewis P., Perez E., Piktus A. і інш. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Dhuliawala S., Komeili M., Xu J. і інш. Chain-of-Verification Reduces Hallucination in Large Language Models. 2023. arXiv:2309.11495 (прэпрынт). https://arxiv.org/abs/2309.11495
- Manakul P., Liusie A., Gales M. J. F. SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models. EMNLP 2023. https://arxiv.org/abs/2303.08896
Вучымся гэтаму на практыцы
У практычных групах AI Sandbox Lab вы працуеце з агентам на сваіх задачах, а не чытаеце пра яго. Пісаць код не трэба.