Памятка AI Sandbox Lab для участников практических групп.
- Для кого: Product Manager, Project Manager, бизнес-аналитик, QA, Engineering Manager и все, кто работает с AI без опыта программирования
- Время чтения: около 15 минут
- Источники: исследования и документация, ссылки проверены 2 ноября 2026 года; номера в квадратных скобках ведут к списку в конце
Карта памятки
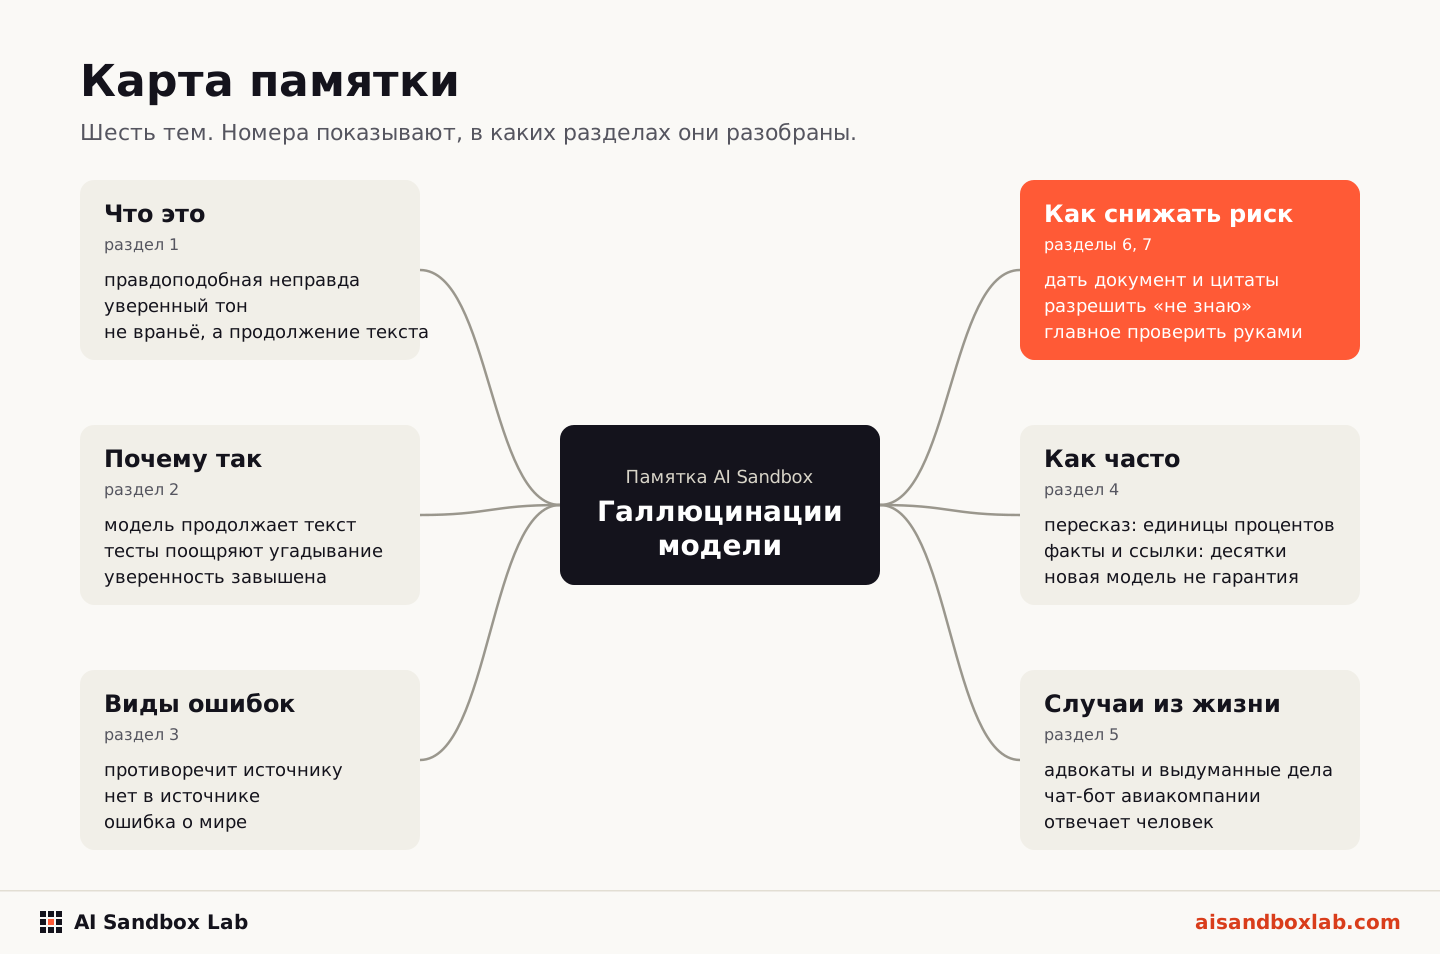
Сразу главное: гладкий текст не равен факту
Модель иногда выдаёт правдоподобную неправду: точную цифру, которой нет, ссылку на несуществующую статью, цитату, которую никто не говорил. Это не поломка конкретного сервиса, а следствие того, как модели устроены и как их обучают. Убрать это полностью нельзя, но риск можно сильно снизить: дать модели ваш документ, разрешить ей сказать "не знаю", требовать цитаты и проверять главное руками. Чем дороже ошибка, тем строже проверка.
1. Что такое галлюцинация
Галлюцинация модели - это правдоподобный, уверенно поданный ответ, который не соответствует действительности или исходным данным. Исследователи описывают её похожим образом: модель выдаёт "правдоподобный, но нефактический" текст [3].
Слово не совсем удачное. У человека галлюцинация - это восприятие того, чего нет. У модели нет ни восприятия, ни намерения соврать. Авторы одной из ключевых работ прямо отмечают, что это явление "принципиально отличается" от человеческого опыта [1]. Поэтому дальше мы будем говорить проще: модель выдала правдоподобную неправду.
Полезно Бытовая аналогия: отличник у доски
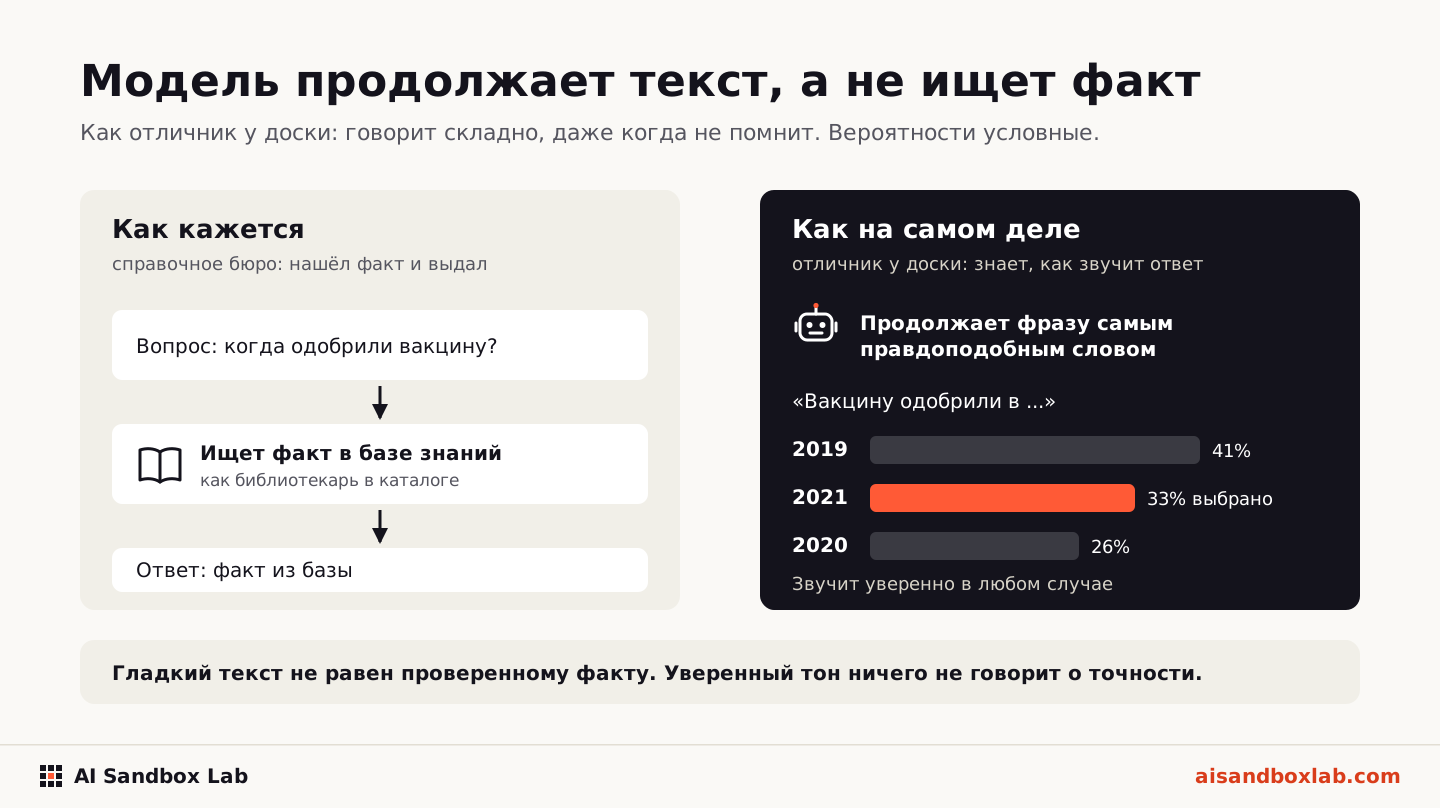
Представьте студента, который выучил, как звучат правильные ответы, но не помнит фактов. Его вызвали к доске, и он знает: молчать нельзя, оценка за пустой ответ хуже, чем за попытку. Он говорит складно, уверенным тоном, в нужной терминологии. Иногда попадает, иногда нет, а по интонации отличить невозможно. Модель устроена похоже: она продолжает текст так, как он обычно звучит, а не сверяется с базой фактов.
2. Почему модель так делает
Коротко, три причины.
1. Модель учится предсказывать текст, а не хранить факты. Она видела огромное количество текстов и научилась продолжать их правдоподобно. Если факт встречался в обучении редко или один раз, модель знает его плохо. Теоретическая работа Калая и Вемпалы показывает: даже при идеальных обучающих данных доля ошибок на таких редких фактах примерно равна доле фактов, встреченных в обучении ровно один раз [4]. Это математический результат для идеализированной модели, а не прямое измерение на конкретном продукте.
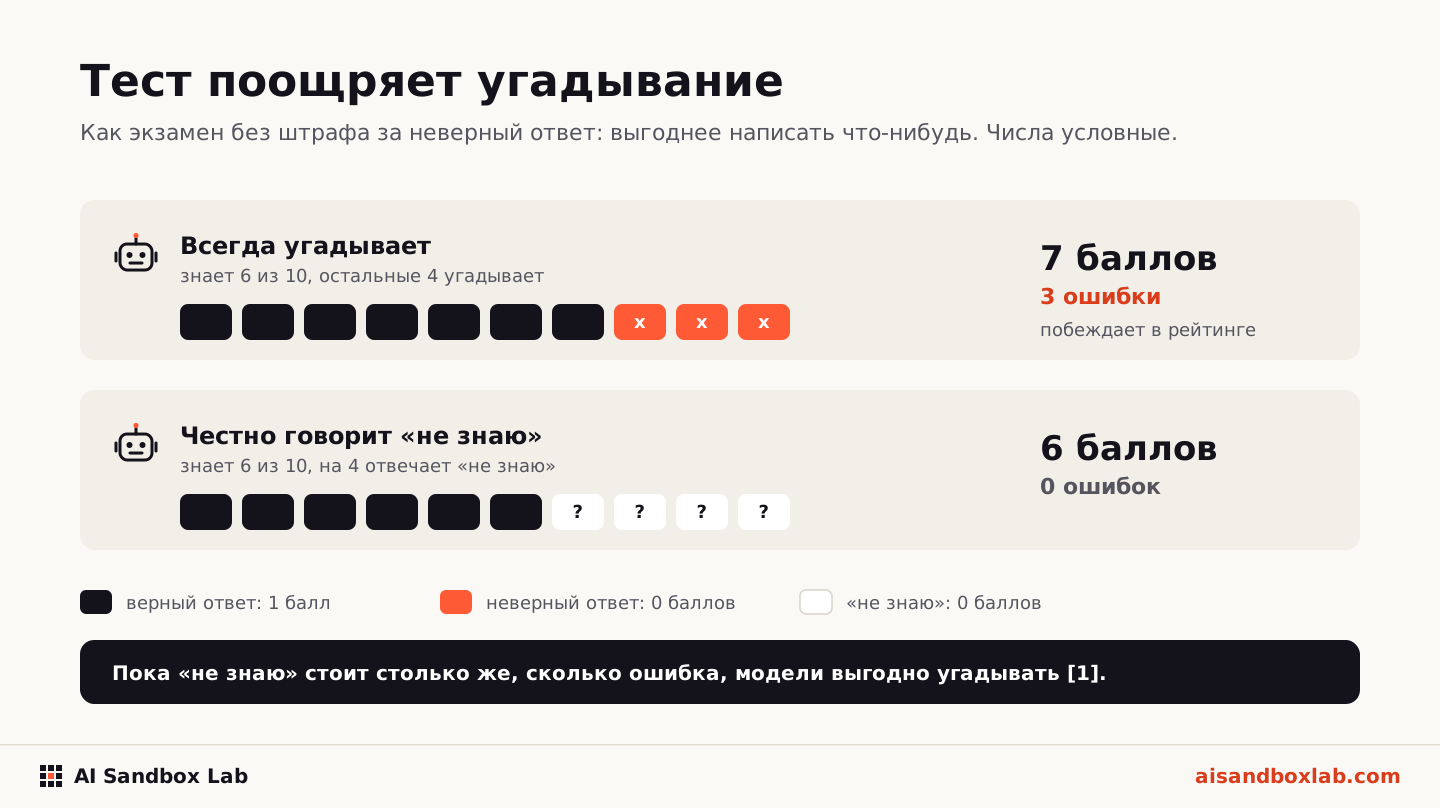
2. Обучение и оценки поощряют угадывание. Это главный вывод свежей работы исследователей OpenAI "Почему языковые модели галлюцинируют" (2025). Большинство тестов, на которых сравнивают модели, ставят 1 балл за верный ответ и 0 за ответ "не знаю". Тогда модель, которая всегда угадывает, набирает больше баллов, чем модель, которая честно признаётся в незнании. Авторы пишут, что обучение и оценка "поощряют угадывание, а не признание неопределённости" [1]. Как студент на экзамене без штрафов за неверный ответ: выгодно писать что-нибудь.
3. Модель плохо оценивает собственную уверенность. В тесте SimpleQA (4 326 коротких фактических вопросов) авторы просили модель назвать свою уверенность в ответе. Вывод: уверенность модели связана с точностью, но модели "последовательно завышают" её [5].
Полезно Два слова, которые встречаются в исследованиях
Калибровка - насколько уверенность ответа совпадает с реальной точностью. Хорошо откалиброванная модель, говоря "я на 70% уверена", права примерно в 70% случаев. Бенчмарк - стандартный набор вопросов, на котором сравнивают модели, как экзамен.
3. Виды галлюцинаций
В научных обзорах чаще всего используют два разделения.
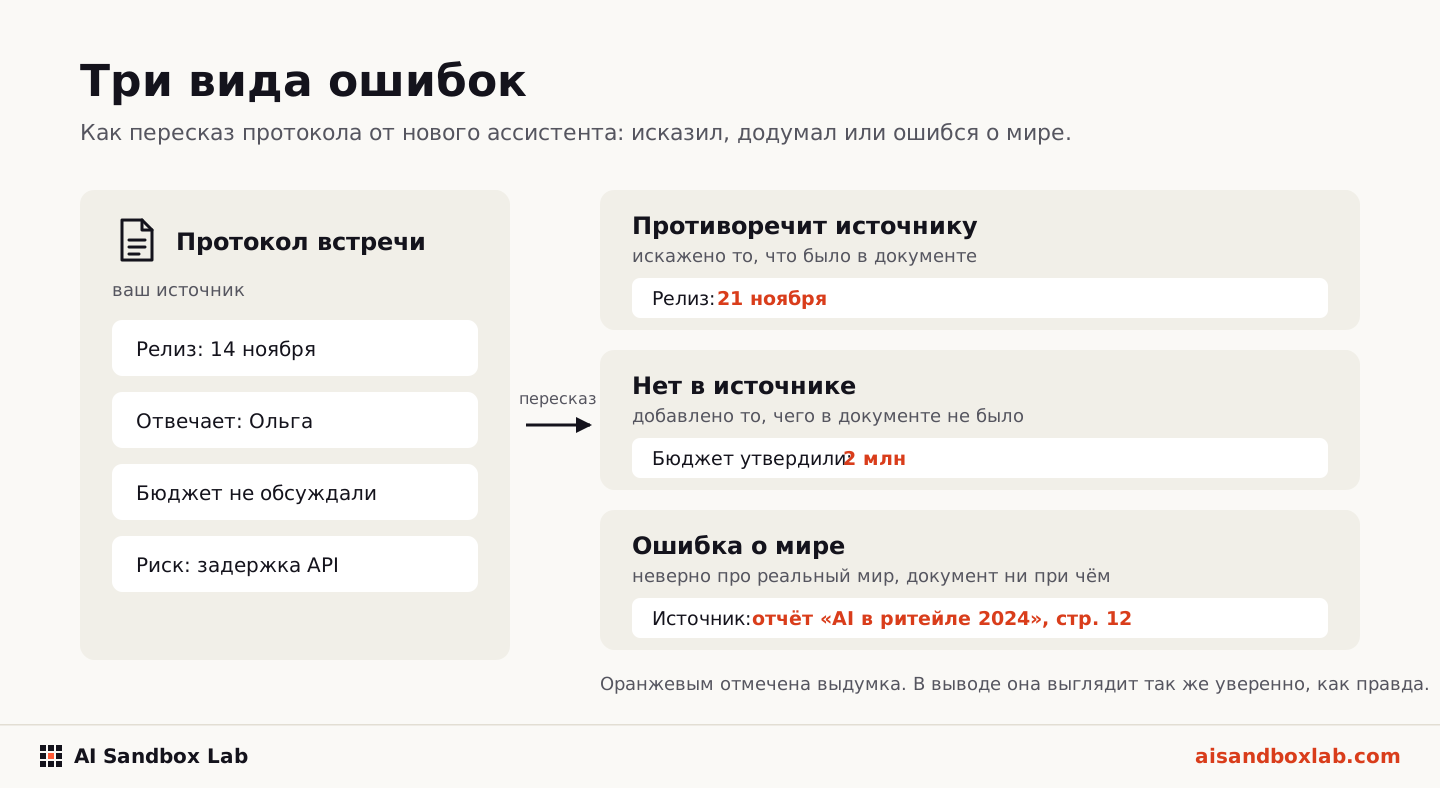
Первое: по отношению к тому, что вы дали модели. Это классификация из обзора Ji и соавторов [2].
- Противоречит вашему источнику. Вы дали документ, а модель в пересказе исказила его. В обзоре пример: в тексте вакцина одобрена в 2019 году, а в пересказе стоит 2021.
- Нельзя проверить по вашему источнику. Модель добавила то, чего в документе нет. Авторы отмечают, что такое добавление не всегда ошибочно, но требует осторожности, потому что проверить его по источнику нельзя.
Второе: ошибка о мире или ошибка о вашей задаче. Обзор Huang и соавторов делит галлюцинации на фактические (расходятся с реальными фактами) и на "верность" (расходятся с вашим вводом или инструкцией) [3].
Как это выглядит в работе:
| Роль | Пример | Вид |
|---|---|---|
| Product Manager | Просите сжать 20 интервью с клиентами. В сводке появляется цитата, которой никто не говорил | не из источника |
| Product Manager | Просите данные о размере рынка. Получаете точную цифру со ссылкой на отчёт, которого не существует | фактическая ошибка |
| Project Manager | Просите пересказать протокол встречи. Срок в пересказе сдвинулся, ответственный указан неверно | противоречит источнику |
| Бизнес-аналитик | Просите выписать требования из регламента. Появляется пункт, которого в регламенте нет | не из источника |
| QA | Просите тест-кейсы по описанию функции. Часть кейсов проверяет поведение, которое никто не обещал | не из источника |
| Engineering Manager | Просите ссылки на статьи про практики оценки команд. Часть названий и авторов выдумана | фактическая ошибка |
Важно
Самый опасный вариант не абсурдный ответ, а правдоподобный: правильный формат, уверенный тон, реальные имена рядом с выдуманными деталями. В исследовании выдуманных библиографических ссылок часть ссылок на существующие работы содержала существенные ошибки в данных (43% у GPT-3.5 и 24% у GPT-4), то есть смесь настоящего и ложного [8].
4. Насколько это часто
Единой цифры "модель врёт в N% случаев" не существует. Частота зависит от задачи, модели, способа проверки и даты. Ниже примеры измерений. Их нельзя усреднять и сравнивать между собой, у них разные задачи.
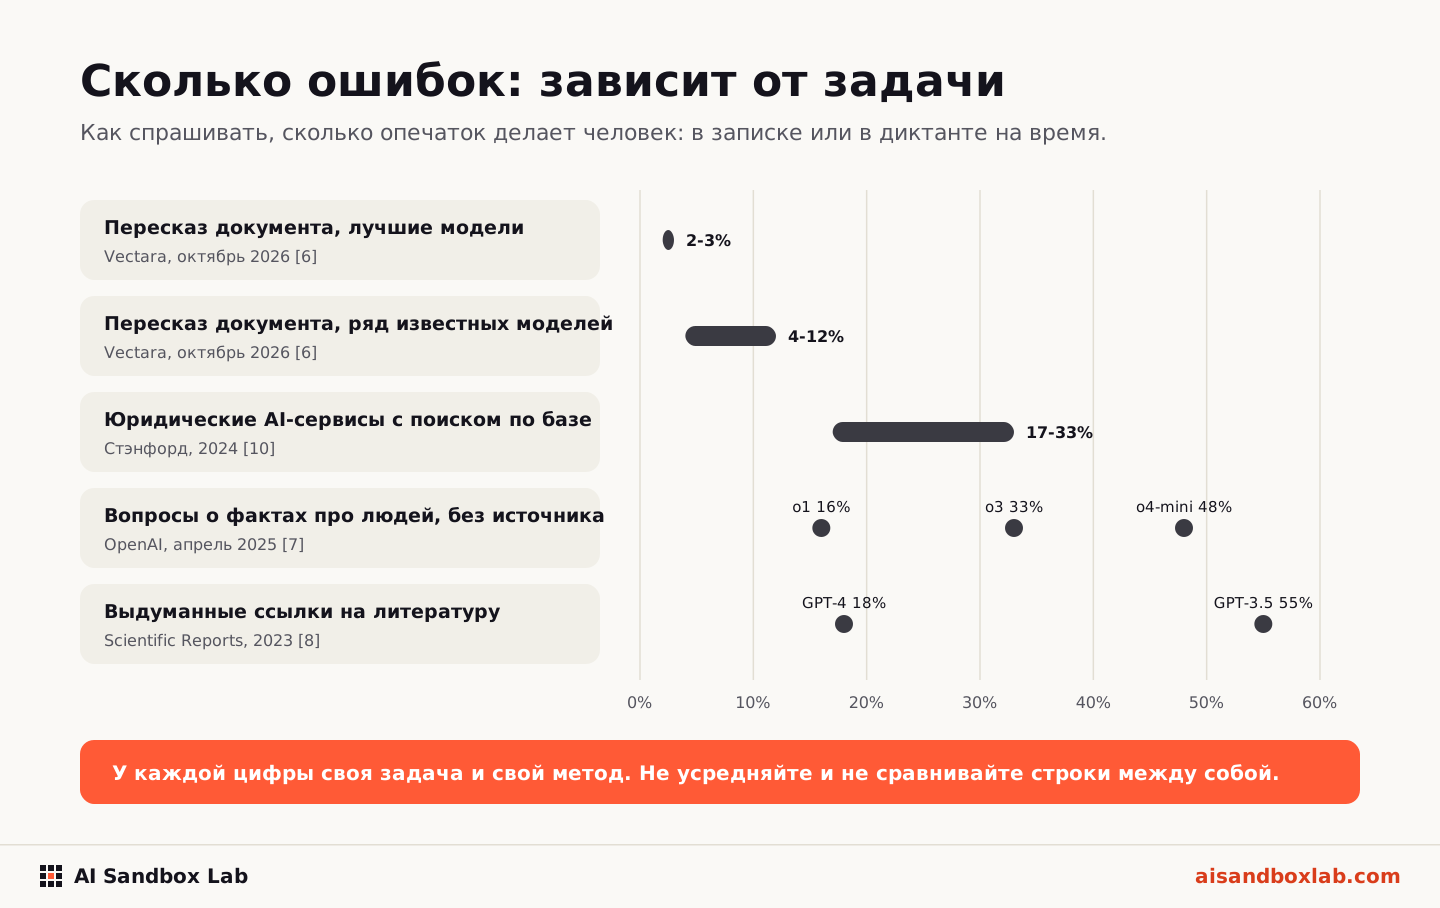
Пересказ документа (самое мягкое условие). Рейтинг компании Vectara измеряет, как часто модель добавляет в краткий пересказ документа то, чего в нём нет. На 22 октября 2026 года в таблице у лучших моделей около 2-3%, у ряда известных моделей 4-12%, у одной из моделей линейки GPT-5 15,1% [6]. Оговорки: это только пересказ коротких текстов, набор документов закрытый, оценку ставит другая модель, а не человек.
Вопросы про факты без источника. На тесте PersonQA (вопросы о публичных фактах про людей) модель o3 от OpenAI по данным разработчика ошибалась в 33% ответов, o4-mini в 48%, предыдущая o1 в 16% [7]. Дата отчёта: апрель 2025. Это внутренний тест вендора.
Ссылки на литературу. В работе Walters и Wilder (2023) ChatGPT писал короткие обзоры по 42 темам, всего 636 ссылок. Выдуманными оказались 55% ссылок у GPT-3.5 и 18% у GPT-4 [8]. Свежее небольшое исследование по стоматологии (15 вопросов, 2025) нашло высокую долю выдуманных ссылок у GPT-4o, а у систем, которые ищут по реальным публикациям, выдуманных ссылок не было, но были ошибки в трактовке [9]. Выборка маленькая, как иллюстрация, не как оценка.
Специализированные юридические AI-инструменты. Команда Стэнфорда проверила коммерческие сервисы юридического поиска, которые продаются как "без галлюцинаций". Они ошибались в 17-33% запросов [10]. Работа 2024 года, версии продуктов с тех пор менялись.
Важная оговорка для выводов. Новые модели не обязательно галлюцинируют меньше. В системной карте OpenAI сказано, что o3 делает больше утверждений, поэтому и верных, и неверных у него больше, а причину исследователи пока не знают [7]. В рейтинге Vectara у gpt-5-high доля 15,1%, у gpt-4o 9,6%, то есть более новая модель оказалась хуже на этой конкретной задаче [6]. Версии и даты у моделей разные, поэтому это наблюдение, а не закон. Вывод: "модель свежая и умная" не заменяет проверку.
Полезно Можно ли довести до нуля
По теоретической работе Xu и соавторов, полностью устранить галлюцинации у языковых моделей невозможно [11]. Это математическое утверждение при определённых допущениях, но практический вывод совпадает с рекомендацией Anthropic в её документации: приёмы значительно снижают галлюцинации, но не устраняют их полностью, а важную информацию нужно проверять [14]. Планируйте процесс с проверкой, а не надейтесь на идеальную модель.
5. Громкие случаи из реальности
Адвокаты и выдуманные дела (США, 2023). В деле Mata v. Avianca адвокат использовал ChatGPT для поиска судебных прецедентов и подал в суд документ с несуществующими делами. Судья Кастел 22 июня 2023 года обязал двух адвокатов и их фирму заплатить 5 000 долларов штрафа, а также уведомить судей, чьи имена были указаны как авторы вымышленных решений. Суд счёл, что адвокаты действовали недобросовестно: после обнаружения проблемы они отстаивали выдуманные дела [12]. Урок не в самой ошибке, а в том, что ответ не проверили и потом защищали.
Чат-бот авиакомпании (Канада, 2024). Чат-бот Air Canada сообщил пассажиру, что скидку на билет в связи с утратой близкого можно оформить после поездки. Реальные правила этого не позволяли. В феврале 2024 года трибунал Британской Колумбии признал авиакомпанию ответственной за слова её чат-бота. Сумма спора была небольшой (около 880 канадских долларов), но решение стало примером: компания отвечает за ответы своего бота [13]. Детали взяты из вторичного источника, ссылка на само решение есть в списке.
Юридические AI-сервисы. Исследование Стэнфорда (см. выше) показало, что даже платные профессиональные инструменты с поиском по базе ошибаются заметно чаще, чем обещают продавцы [10].
6. Как снижать риск
Идея всех приёмов одна: не просить модель вспоминать, а давать ей материал и требовать опираться на него. Подход, где модель сначала достаёт нужные документы, а потом отвечает, в науке называется RAG (поиск + генерация) и появился в работе Lewis и соавторов (2020), где такая схема дала более точные и фактологичные тексты, чем модель без поиска [15]. RAG не отменяет ошибок: в юридическом исследовании [10] инструменты с поиском всё равно ошибались, а в стоматологическом [9] системы с поиском не придумывали ссылок, но неверно трактовали найденное.
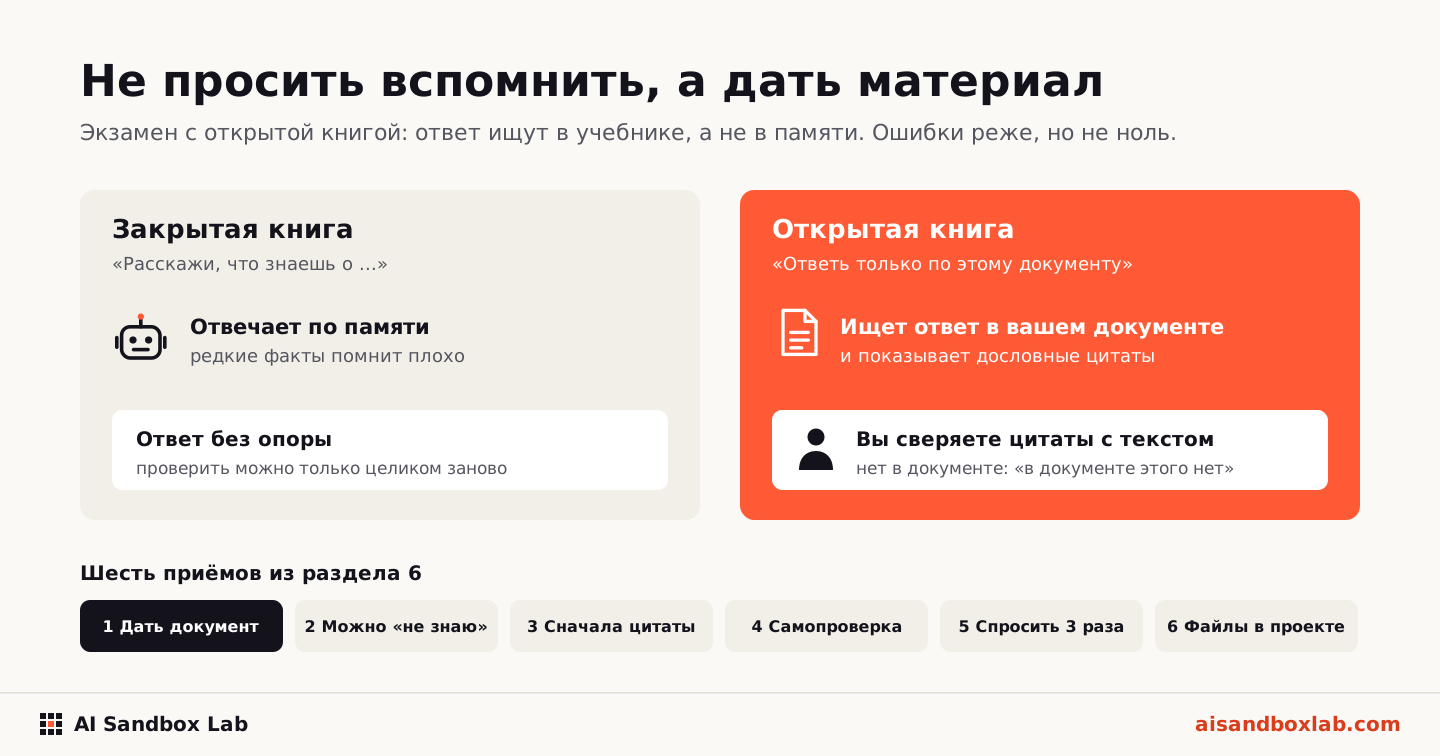
Практика Приём 1. Дайте документ и ограничьте источник
Рекомендация из документации Anthropic: попросить использовать только предоставленные документы, а не общие знания [14].
Отвечай только на основе документа ниже. Не используй общие знания.
Если в документе нет ответа, напиши: "В документе этого нет".
<документ>
(вставьте текст)
</документ>
Вопрос: (ваш вопрос)
Практика Приём 2. Разрешите сказать "не знаю"
Anthropic пишет, что явное разрешение признать неуверенность может резко снизить число ложных утверждений [14]. Это связано и с причиной из раздела 2: по умолчанию модель чувствует себя обязанной ответить.
Если не уверен в ответе или не хватает данных, так и скажи:
"Не уверен" или "Не хватает данных". Не додумывай.
Отдельно перечисли, что в ответе ты знаешь точно, а что предполагаешь.
Практика Приём 3. Сначала цитаты, потом выводы
Для длинных документов Anthropic советует сначала попросить дословные цитаты, а выводы делать только по ним [14].
Сначала выпиши дословные цитаты из документа, относящиеся к вопросу, с номерами.
Если подходящих цитат нет, напиши "Цитат не найдено".
Затем сделай вывод, ссылаясь на номера цитат. Ничего сверх цитат не добавляй.
Практика Приём 4. Пусть модель сама проверит черновик
Метод Chain-of-Verification (Dhuliawala и соавторы, 2023): модель пишет черновик, формулирует проверочные вопросы, отвечает на них отдельно от черновика и выдаёт исправленный итог. Авторы сообщают, что это снижает галлюцинации в нескольких тестах [16]. Это препринт, не рецензируемая статья. Ниже упрощённая версия для чата.
Ты написал ответ выше. Теперь:
1. Выпиши все проверяемые утверждения (цифры, даты, имена, ссылки).
2. Для каждого сформулируй вопрос для проверки и ответь на него, не глядя на черновик.
3. Сравни. Что не подтвердилось, убери или пометь.
4. Выдай исправленный ответ.
Оговорка: модель проверяет саму себя, поэтому это помогает не всегда. Главные проверки (цифры, ссылки, юридические и финансовые факты) делайте по первоисточнику.
Практика Приём 5. Задайте вопрос несколько раз
Идея из метода SelfCheckGPT: если модель знает тему, повторные ответы совпадают, а выдуманные детали от раза к разу меняются [17]. Anthropic рекомендует тот же приём: запустить один запрос несколько раз и сравнить, расхождения могут указывать на галлюцинацию [14]. Задайте один вопрос в трёх новых чатах. Всё, что не совпало, проверьте руками. Совпадение не доказывает правоту: модель может последовательно повторять одну и ту же ошибку.
Практика Приём 6. Для агентов в IDE: источник в папке проекта
Если вы работаете с агентом (Cursor, Claude Code, Antigravity), положите нужные документы в папку проекта и в правила (CLAUDE.md или AGENTS.md) добавьте строку:
Фактами считаем только то, что есть в файлах проекта.
Если факта нет в файлах, пиши "нужно уточнить", а не придумывай.
К каждому важному выводу добавляй имя файла и цитату.
7. Чек-лист: как проверить ответ модели
Проверка нужна не всегда. Чем выше цена ошибки, тем строже проверка.
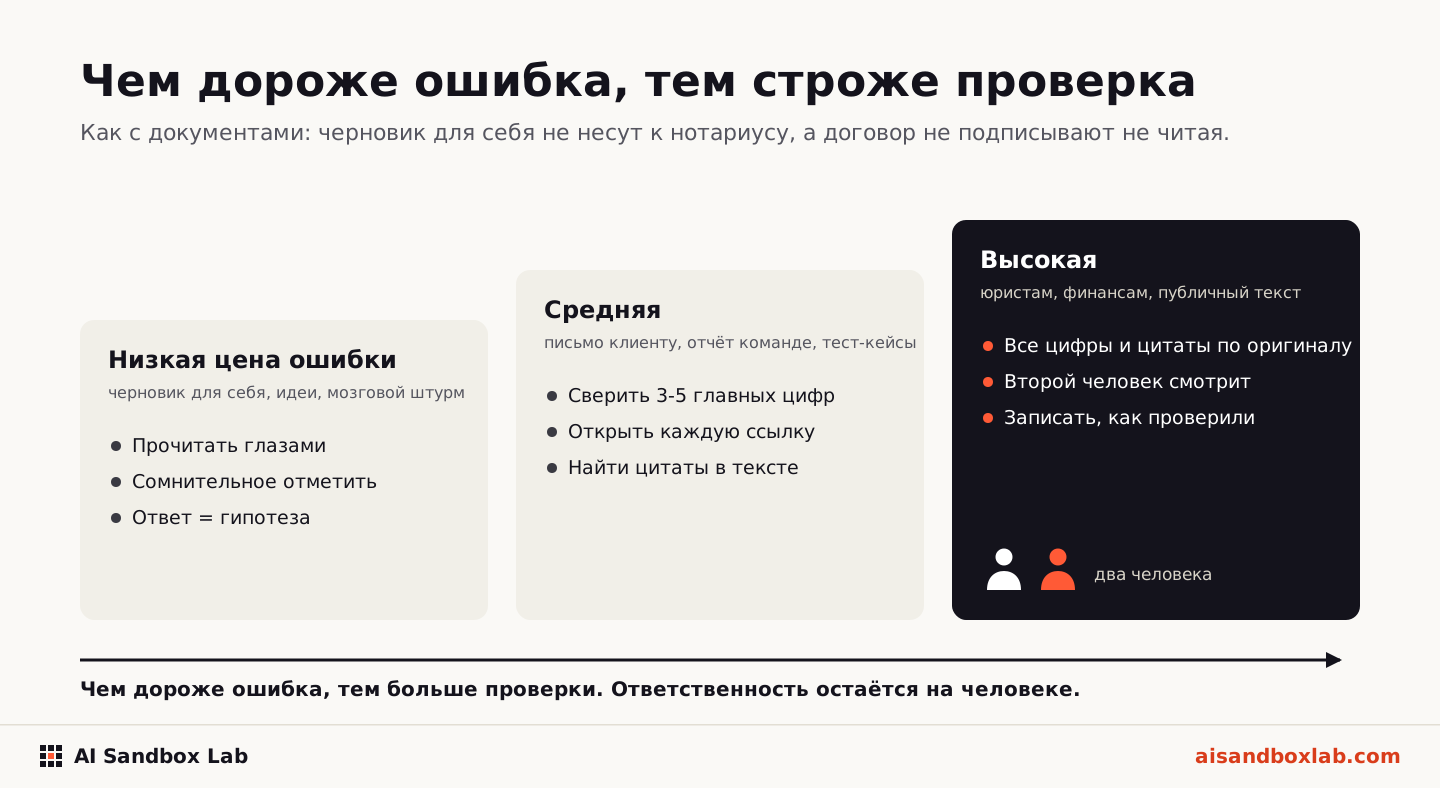
- Цена ошибки. Это черновик для себя, письмо клиенту или документ для юристов и бухгалтерии? Чем выше, тем больше проверки.
- Есть ли источник? Просили ли вы опираться на ваш документ? Если нет, считайте ответ гипотезой.
- Цифры, даты, имена. Выберите 3-5 самых важных и сверьте с первоисточником. Если все совпали, шанс на ошибку ниже, но не нулевой.
- Ссылки и цитаты. Откройте каждую ссылку. Убедитесь, что страница существует и в ней сказано то, что приписывает модель. Название статьи реальное, а вывод из неё выдуманный: частый вариант.
- Дословные цитаты. Найдите цитату в документе поиском по тексту (Ctrl+F). Нет в документе, значит выдумана.
- Ответ слишком гладкий. Нет оговорок, нет "не знаю", идеально подходит под ваш запрос. Это повод насторожиться.
- Повторите вопрос. Ответы расходятся в деталях? Проверьте именно эти детали.
- Спросите "откуда это?" Попросите назвать источник и цитату. Не смогла, значит нет опоры. Но помните: модель может выдать и выдуманный источник, поэтому открывайте его сами.
- Второй человек. Для важных решений пусть коллега посмотрит выводы и источники.
- Запишите, как проверили. Одна строка в документе: "цифры сверены с отчётом X, ссылки открыты". Так вы сможете повторить проверку.
Важно
Ответственность за результат остаётся на человеке. В обоих громких случаях выше виноватой признали не модель, а тех, кто пользовался её ответом без проверки или выпустил бота без контроля [12][13].
Что забрать с собой
- Галлюцинация - это не сбой, а следствие того, как модель устроена и как её оценивают [1][4].
- Частота зависит от задачи: пересказ документа - единицы процентов, вопросы про редкие факты и ссылки на литературу - десятки процентов [6][7][8].
- Новая модель не гарантирует меньше ошибок [6][7].
- Лучший способ снизить риск: дать документ, разрешить "не знаю", требовать цитаты и проверять главное руками [14][15].
Приложение А. Словарик
| Термин | Простыми словами |
|---|---|
| Модель, языковая модель | Программа, которая научилась продолжать текст на огромном количестве примеров. ChatGPT, Claude, Gemini работают на таких моделях. |
| Галлюцинация | Правдоподобный и уверенный ответ, который не соответствует фактам или вашему документу. |
| Промпт | Текст запроса, который вы отправляете модели. |
| Источник, документ | Материал, который вы даёте модели: протокол, регламент, отчёт, таблица. По нему потом проверяют ответ. |
| Калибровка | Насколько уверенность модели совпадает с её реальной точностью. Как прогноз погоды: если "70% дождя" сбывается в 7 случаях из 10, прогноз откалиброван. |
| Бенчмарк | Стандартный набор вопросов, на котором сравнивают модели. Как единый экзамен для всех. |
| RAG (поиск + генерация) | Схема, при которой модель сначала находит нужные документы, а потом отвечает по ним. Экзамен с открытой книгой. |
| Chain-of-Verification | Приём самопроверки: черновик, проверочные вопросы, ответы на них, исправленный итог (раздел 6, приём 4). |
| SelfCheckGPT | Способ поймать выдумку по расхождениям: один и тот же вопрос задают несколько раз и сравнивают ответы (раздел 6, приём 5). |
| Системная карта | Отчёт разработчика модели о её возможностях, тестах и рисках. Пишет сам вендор. |
| Препринт | Научная статья, выложенная до рецензии другими учёными. Полезна, но проверена слабее журнальной. |
| Агент | Модель, которая не только отвечает в чате, но и сама выполняет шаги: читает файлы, ищет, правит документы. |
| CLAUDE.md, AGENTS.md | Файл с правилами проекта, который агент читает в начале работы. Туда удобно записать правило "факты только из файлов". |
Приложение Б. Источники
Дата проверки ссылок: 2 ноября 2026 года.
- Kalai A. T., Nachum O., Vempala S. S., Zhang E. Why Language Models Hallucinate. 2025. arXiv:2509.04664 (препринт). https://arxiv.org/abs/2509.04664
- Ji Z., Lee N., Frieske R. и др. Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, т. 55, вып. 12, 2023. https://doi.org/10.1145/3571730 (препринт: https://arxiv.org/abs/2202.03629)
- Huang L., Yu W., Ma W. и др. A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions. ACM Transactions on Information Systems, 2024/2025. https://doi.org/10.1145/3703155 (препринт: https://arxiv.org/abs/2311.05232)
- Kalai A. T., Vempala S. S. Calibrated Language Models Must Hallucinate. STOC 2024 (препринт 2023). https://arxiv.org/abs/2311.14648
- Wei J., Karina N., Chung H. W. и др. Measuring short-form factuality in large language models (SimpleQA). OpenAI, 2024. arXiv:2411.04368 (препринт). https://arxiv.org/abs/2411.04368
- Vectara. Hallucination Leaderboard (HHEM). Живой рейтинг, на момент проверки обновлён 22.10.2026. https://github.com/vectara/hallucination-leaderboard
- OpenAI. OpenAI o3 and o4-mini System Card. 16 апреля 2025. https://cdn.openai.com/pdf/2221c875-02dc-4789-800b-e7758f3722c1/o3-and-o4-mini-system-card.pdf
- Walters W. H., Wilder E. I. Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045, 2023. https://doi.org/10.1038/s41598-023-41032-5
- Hooshiar M. H. Artificial intelligence reliability in implant dentistry: a comparative analysis of clinical accuracy and hallucination patterns across multiple language models. Journal of Prosthetic Dentistry, 135(5), e155-e161, 2025. https://doi.org/10.1016/j.prosdent.2025.11.005 (по данным PubMed, только аннотация)
- Magesh V., Surani F., Dahl M., Suzgun M., Manning C. D., Ho D. E. Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. 2024. arXiv:2405.20362 (препринт). https://arxiv.org/abs/2405.20362
- Xu Z., Jain S., Kankanhalli M. Hallucination is Inevitable: An Innate Limitation of Large Language Models. 2024. arXiv:2401.11817 (препринт). https://arxiv.org/abs/2401.11817
- Mata v. Avianca, Inc., № 22-cv-1461, S.D.N.Y., решение о санкциях от 22.06.2023 (судья П. К. Кастел). Пересказ: ABA Journal, "Lawyers who doubled down and defended ChatGPT's fake cases must pay $5K, judge says". https://abajournal.com/web/article/lawyers-who-doubled-down-and-defended-chatgpts-fake-cases-must-pay-5k-judge-says
- Moffatt v. Air Canada, 2024 BCCRT 149, Civil Resolution Tribunal of British Columbia, 14.02.2024. Решение: https://decisions.civilresolutionbc.ca/crt/crtd/en/525448/1/document.do (сам текст не удалось открыть автоматически; детали по вторичному источнику: https://en.wikipedia.org/wiki/Moffatt_v._Air_Canada)
- Anthropic. Reduce hallucinations (документация Claude). https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations
- Lewis P., Perez E., Piktus A. и др. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Dhuliawala S., Komeili M., Xu J. и др. Chain-of-Verification Reduces Hallucination in Large Language Models. 2023. arXiv:2309.11495 (препринт). https://arxiv.org/abs/2309.11495
- Manakul P., Liusie A., Gales M. J. F. SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models. EMNLP 2023. https://arxiv.org/abs/2303.08896
Учимся этому на практике
В практических группах AI Sandbox Lab вы работаете с агентом на своих задачах, а не читаете о нём. Код писать не нужно.
Read in English · Чытаць па-беларуску