Зачем вообще уровни
Когда человек говорит "я пользуюсь AI", чаще всего это значит одно: открываю ChatGPT, задаю вопрос, копирую ответ в свой документ. Это нормальный старт. Но между этим и тем, как работают люди, у которых AI реально экономит дни, большая разница. И она не в знании промптов, а в способе работы.
Уровни нужны, чтобы назвать этот способ и увидеть следующий шаг. Уровень описывает, как вы работаете сейчас, а не вашу профессию, должность или талант. Его можно поменять за несколько недель.
Четыре уровня коротко
- 01AI в чатеAI-консумер
Вы спрашиваете, AI отвечает, вы копируете ответ. Как заказать еду: привезли готовое, но кухня не ваша.
Итог: ответ в окне чата - 02Вайбкодерсобирает словами
Описываете словами, что нужно, и AI собирает работающую вещь: страницу, таблицу, прототип. Как готовить по рецепту из интернета: вкусно, но повторить так же не факт.
Итог: прототип, который работает у вас - 03Агентный инженерработает по системе
У агента есть папка проекта, правила, навыки и проверка. Своя книга рецептов: продукты, рецепт, проба на вкус. Блюдо повторяется.
Итог: навык или процесс для повторяющейся задачи - 04AI-архитекторстроит для команды
Собирает систему из нескольких агентов и подключений, которой пользуется команда. Кухня ресторана: повара, роли, правила. Работает и без вас.
Итог: система для команды
Уровень описывает способ работы, а не профессию или талант.
Несколько слов, которые здесь встретятся:
- Вайбкодинг - вы описываете результат обычными словами, а код пишет AI. Вы его не пишете и не читаете.
- Агент - AI, который не только отвечает, но и сам действует: открывает файлы на вашем компьютере, создаёт новые, запускает проверки. Например, Claude Code, Codex или Cursor.
- Навык (skill) - сохранённая инструкция для агента. Один раз описали, как делать задачу, дальше агент делает её по этой инструкции.
- CLAUDE.md - файл с правилами проекта, который агент читает в начале каждой задачи. У Codex такой файл называется AGENTS.md.
Названия уровней 2 и 3 не мы придумали. Слово "vibe coding" в феврале 2025 года ввёл Андрей Карпатый, один из основателей OpenAI и бывший директор по AI в Tesla. Ровно через год он сам назвал его вчерашним днём и предложил для профессиональной работы с агентами другое название: agentic engineering, агентная инженерия. В вайбкодинге вы просите и надеетесь, что сработает. В агентной инженерии вы ставите задачу, читаете план агента и проверяете результат. Слово "инженер" пусть не пугает: программировать там тоже не нужно, речь о дисциплине.
И чат никуда не девается. Для быстрого вопроса он удобен на любом уровне. Меняется то, как вы делаете серьёзную работу.
Одна задача на четырёх уровнях
Проще всего увидеть разницу на одной и той же работе. Возьмём еженедельный статус-отчёт для руководителя: выгрузка задач из Jira, заметки со встреч, риски.
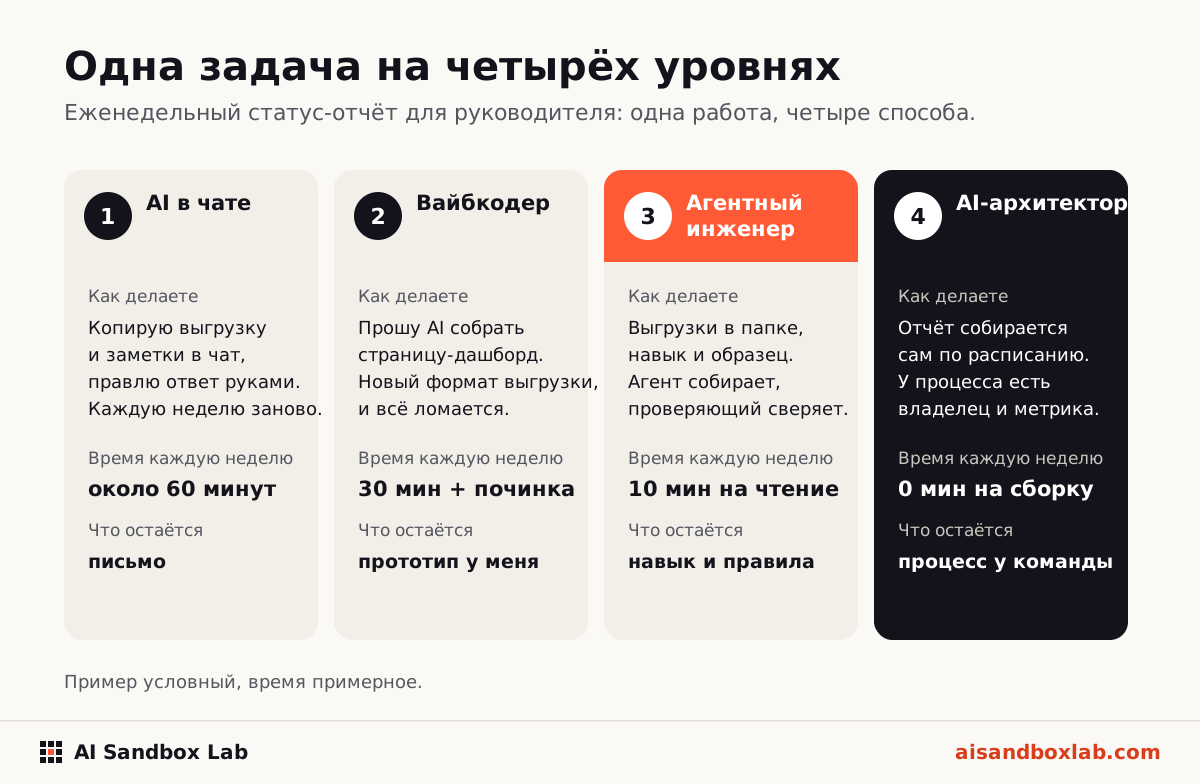
- В чате вы каждую неделю заново копируете выгрузку и заметки, просите сводку, правите её руками и переносите в письмо. От недели к неделе не остаётся ничего, кроме самого письма.
- Вайбкодер просит AI собрать страницу-дашборд из выгрузки. Выглядит впечатляюще, пока в Jira не поменяют поле и всё не сломается. Прототип живёт у вас и только у вас.
- Агентный инженер один раз заводит папку: выгрузки, образец хорошего отчёта, навык "собери статус" и правила. Дальше одна фраза агенту, второй агент сверяет цифры с выгрузкой, вы читаете готовый отчёт десять минут.
- AI-архитектор подключает Jira напрямую, отчёт собирается сам по расписанию и приходит всей команде. Время уходит уже не на сборку, а на то, чтобы процесс работал: у него есть владелец и понятная метрика качества.
Обратите внимание на строку "что остаётся". Между уровнями растёт не скорость сама по себе, а то, что накапливается от недели к неделе.
Как понять, где вы
Вспомните свою обычную рабочую неделю и найдите столбец, который больше на неё похож.
| Признак | 1. AI в чате | 2. Вайбкодер | 3. Агентный инженер | 4. AI-архитектор |
|---|---|---|---|---|
| Где работает AI | чат в браузере | один AI-сервис, который собирает приложения | агент в папке проекта на компьютере | несколько агентов, подключения, доступы |
| Откуда AI знает задачу | объясняете заново в каждом чате | прикладываете файлы вручную | правила и примеры лежат в проекте | контекст, доступы и память разделены |
| Что получается | ответ, текст, совет | прототип, который работает у вас | навык или процесс для повторяющейся задачи | система, которой пользуется команда |
| Как проверяете | читаете: выглядит нормально | пробуете основной сценарий | критерии готовности задаёте заранее | автоматические проверки и разбор ошибок |
| Повторить через неделю | ищете старый удачный запрос | есть сохранённый запрос | есть навык и шаблон результата | общий каталог, у процесса есть владелец |
| Кто ещё пользуется | только вы, эксперименты | вы сами, регулярно | коллега, по вашей инструкции | команда, по общим правилам |
Если ваша неделя попадает в два соседних столбца, это нормально. Чаще всего это и значит, что вы на переходе. И уровень зависит не от инструмента: в Claude Code можно работать как в чате, а в чате можно держать очень дисциплинированный процесс. Важно то, как вы работаете. Это видят и большие компании: в EPAM, где переучивают на работу с агентами десятки тысяч инженеров, руководитель AI-инженерии Дмитрий Товпеко говорит, что одни и те же инструменты дают в руках разных людей очень разный результат, и этот разрыв растёт.
Что на самом деле отличает уровень 3
Переход со второго уровня на третий самый важный и самый непонятный. Снаружи он выглядит как "поставил другую программу". На деле меняются две вещи: у агента появляется постоянное рабочее место, и у работы появляется цикл.
Рабочее место
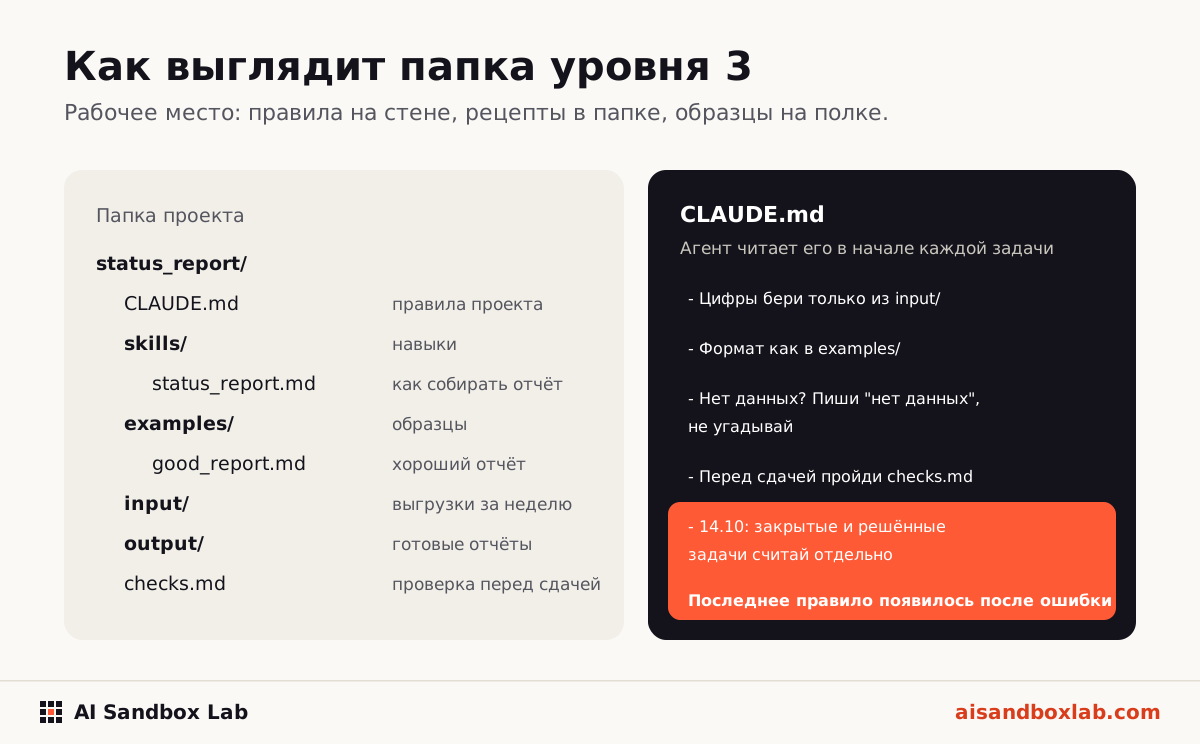
На втором уровне всё знание о задаче живёт у вас в голове и в истории чата. На третьем оно лежит в папке, и агент читает его сам: правила проекта, инструкцию для повторяющейся задачи, образец хорошего результата, исходные данные и список того, что проверить перед сдачей. Поэтому завтра задача делается так же, как сегодня, даже если вы забыли половину деталей.
Цикл работы
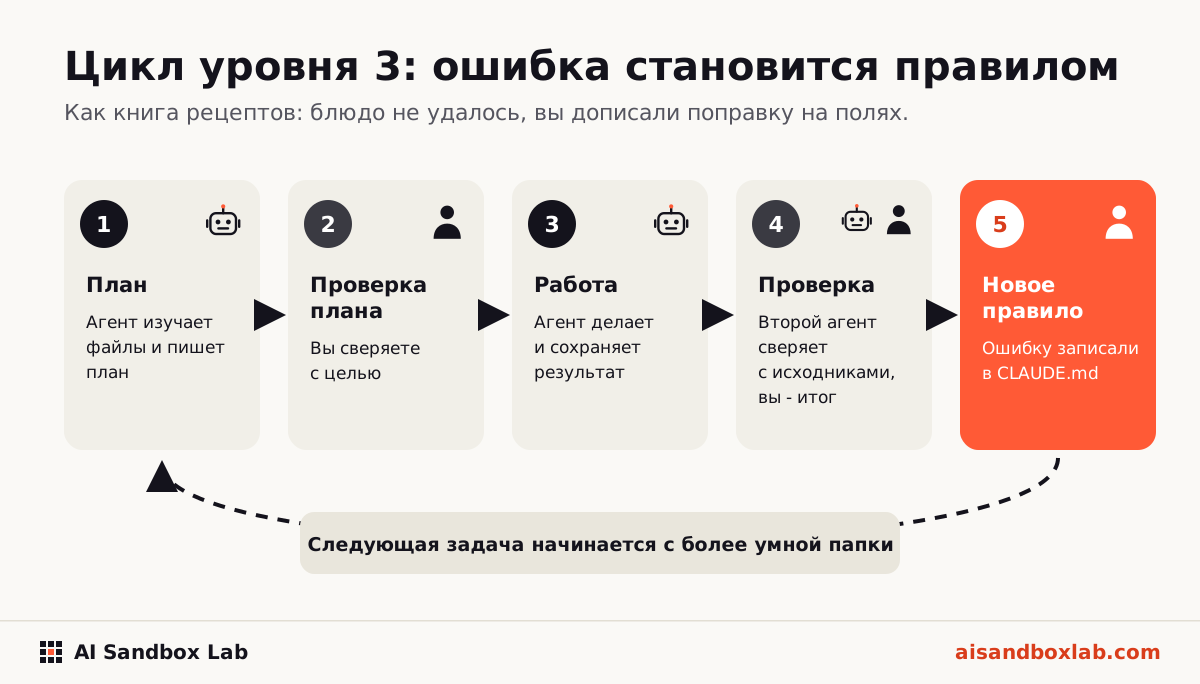
Так работают и люди, которые делают эти инструменты. Anthropic в своих рекомендациях к Claude Code советует сначала попросить план и только потом исполнение, а главное - дать агенту способ проверить свою работу. Борис Черный, создатель Claude Code, рассказывает, что его команда держит общий файл правил и дописывает туда правило каждый раз, когда Claude ошибся. Карпатый формулирует то же самое короче: выигрывает тот, у кого быстрее цикл "AI сделал, человек проверил".
EPAM в презентации для инвесторов (август 2026) показала, как меняются навыки её инженеров. Среди растущих: ставить задачи AI-агентам и проверять их работу, выстраивать процесс работы с AI и вести несколько потоков работы с агентами параллельно. Среди уходящих - ручные "шлюзы" проверки, когда человек сам перепроверяет каждый шаг вместо того, чтобы встроить проверку в процесс. Это почти дословно описание нашего уровня 3.
Честная оговорка: в EPAM этот профиль называют full-stack agentic engineer и подчёркивают, что он вырастает из сильной инженерной базы, а не из короткой переподготовки. Для нетехнаря уровень 3 означает ту же дисциплину - папку, правила, план и проверку, - но в своей работе: в требованиях, отчётах, тест-кейсах и прототипах, а не в продакшен-коде.
Для нетехнаря в этом нет ничего инженерного. План и проверка - родной жанр аналитика, проджекта и тестировщика. Новое только одно: последний шаг цикла. Если агент ошибся, вы не просто исправляете результат, а дописываете правило, и в следующий раз он эту ошибку учтёт. Через месяц такой работы папка знает о задаче больше, чем любой отдельный чат.
Ловушка каждого уровня и как подняться выше
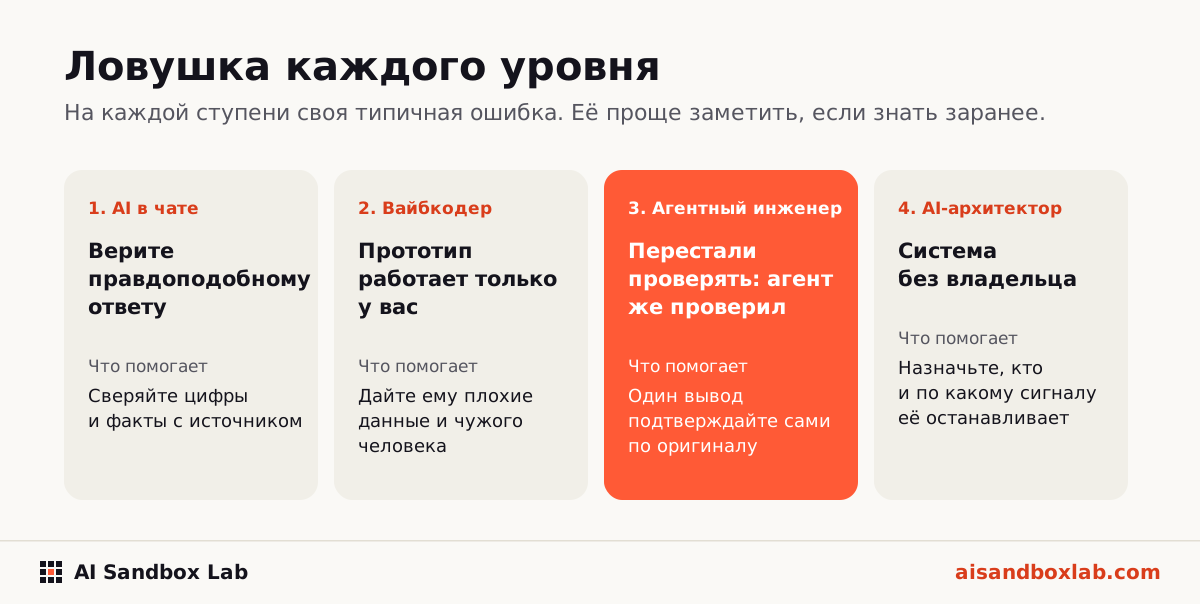
Каждый переход упирается не в новые термины, а в одну конкретную вещь. Ниже она и небольшое задание, которое помогает её сдвинуть.
С уровня 1 на уровень 2
Что мешает: нет ни одного результата, который не просто отвечает, а запускается и что-то делает.
Задание на 30 минут. Возьмите повторяющуюся задачу: сводку, бриф или разбор заметок. Создайте отдельную папку, положите туда исходник и попросите AI-инструмент, который умеет работать с файлами, сохранить результат в новый файл. Готово, когда в папке лежат исходник, инструкция и готовый файл, и завтра вы повторите это без поиска старого чата.
С уровня 2 на уровень 3
Что мешает: не сложность кода. Нужны постоянный контекст, критерии проверки и повторяемый процесс. Показательно, что в AI-буткемпе EPAM для студентов-программистов первым делом разбирают разницу между vibe coding и spec-driven development, работой по спецификации, и учат AI-инженерию как дисциплину, "not as prompt hacking".
Задание на один вечер. Возьмите свой прототип. Запишите три признака готовности, дайте ему нормальный и заведомо плохой вход, затем исправьте самый опасный сбой. Удачный процесс сохраните как навык, а найденную ошибку - как правило в CLAUDE.md. Готово, когда основной сценарий проходит два раза подряд, а известное ограничение записано рядом с проектом.
С уровня 3 на уровень 4
Что мешает: вы проектируете выполнение задачи, но ещё не систему вокруг неё: подключения, границы доступа, контроль качества и работу других людей с ней.
Задание на неделю. Передайте один свой процесс коллеге вместе с короткой инструкцией. Первые 20 минут не помогайте, только записывайте, где человек останавливается. Готово, когда коллега дошёл до результата, а у вас есть три места, где процесс или инструкцию нужно доработать.
На уровне 4
Дальше рост зависит от надёжности, экономики и того, приживается ли система у других людей. Для сравнения: сам Черный параллельно ведёт пять-десять сессий Claude. Это уже управление несколькими агентами, и для большинства задач нетехнаря оно избыточно. Хороший вопрос к себе на этом уровне: кто и по какому сигналу остановит систему, если качество начнёт падать?
Уровень выбирают под задачу
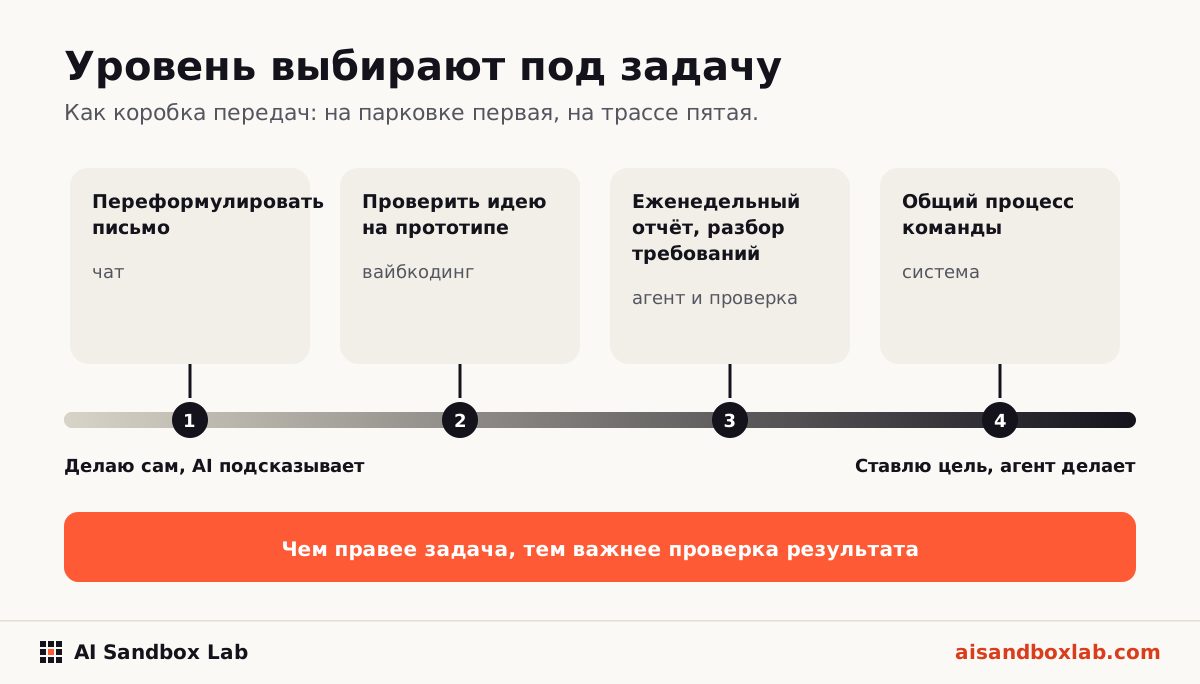
Уровень не ранг, который получают раз и навсегда. Карпатый называет это ползунком автономии: для каждой задачи вы решаете, сколько отдать AI. Даже инженеры Anthropic говорят, что могут полностью отдать AI только 0-20% своей работы (опрос 132 сотрудников, декабрь 2025). Уровень 3 не значит, что каждую задачу надо делать агентом. Он значит, что вы умеете это сделать, когда задача того стоит.
И чем правее задача на ползунке, тем важнее проверка. В исследовании Anthropic AI Fluency Index (февраль 2026, 9 830 диалогов) видно: когда AI выдаёт готовый результат, люди на 5,2 процентного пункта реже замечают, что ему не хватило контекста, и на 3,7 пункта реже проверяют факты. А в эксперименте METR опытные разработчики с AI работали на 19% медленнее, хотя были уверены, что быстрее. Это исследование начала 2025 года, сами авторы считают его устаревшим, но вывод остаётся: ощущение скорости не равно скорости.
Отсюда правило для любого уровня. Перед тем как отдать AI задачу, ответьте на три вопроса: что я отдаю, что я проверю и за что отвечаю сам. OpenAI в гайде для инженерных команд называет это Delegate, Review и Own.
Что говорят другие
Мы сверили нашу шкалу примерно с двадцатью опубликованными лестницами и моделями. Готовой лестницы "консумер, билдер, архитектор" от крупной компании нет, каждый смотрит со своей стороны. Самое полезное:
- Андрей Карпатый дал языку оба наших средних уровня: vibe coding (2025) и agentic engineering (2026).
- Anthropic, AI Fluency (2025). Четыре навыка: Delegation (решить, что отдать AI), Description (понятно описать задачу), Discernment (оценить результат) и Diligence (отвечать за результат). И три режима работы: Automation, Augmentation и Agency. Agency - настроить AI так, чтобы он сам выполнял будущие задачи за вас. Это наш уровень 3.
- EPAM (2026). Публичной шкалы уровней для людей у EPAM нет, но в открытых материалах для инвесторов компания описывает, к какому профилю переучивает инженеров, и подчёркивает, что меняется работа не только разработчиков: продавцы, аккаунт- и деливери-менеджеры тоже переходят на агентные инструменты.
- Section, AI Proficiency Report (июнь 2026). 5 026 офисных сотрудников в США, часть навыков проверяли практическим тестом. 73,5% пользуются AI часто, но разово, без повторяемых процессов. Встроили AI в повторяемую работу только 5,5%. Оговорка: Section сам продаёт обучение AI, так что цифры стоит читать как ориентир.
Похожие лестницы есть у Zapier (по ней оценивают кандидатов при найме), у Microsoft (три фазы компании от "человек с ассистентом" до "агенты ведут процессы под руководством людей") и у Дэна Шапиро для разработчиков. Ссылки внизу.
Пример: Lead BA за один поток
"То, на что раньше уходили часы и требовались консультации коллег, я часто могу сделать сама."
Ольга, Lead Business Analyst, участница AI Sandbox Lab. Разложим её отзыв по шкале:
- До интенсива: уровень 1. "Я читала статьи, держала десятки вкладок открытыми, но не понимала, как начать применять AI в работе."
- Во время интенсива: уровень 2. Первый небольшой проект, выложенный на GitHub: конкретный результат, которым можно поделиться.
- Сейчас: уровень 3. Агенты и навыки для discovery: правильные вопросы к задаче, проверка кодовой базы, зависимостей и блокеров.
- Первые шаги к уровню 4. Шаблоны, которыми она делится с командой, и внутренние проекты, которые она инициирует.
Самое заметное изменение в её отзыве не про инструменты, а про страх, что AI её заменит. Он ушёл, когда появился первый результат, сделанный своими руками. Разметка по шкале моя, а не результат теста.
Как проверить себя
Точнее уровень покажет самодиагностика на сайте: 11 вопросов про то, что вы реально делаете, 3 минуты, результат сразу и без регистрации. Вместе с уровнем вы получите главный пробел и три следующих шага.
Пройдите её дважды: сейчас и через месяц. Разница между двумя результатами и есть ваш прогресс.
Почему вопросы про то, что вы делаете, а не про то, что знаете? Chief Learning Scientist EPAM Сандра Лафлин назвала метрики вроде "сколько людей прошли курс" иллюзией компетентности: навык считается, только если вы применяете его в реальной работе. С самооценкой "я неплохо разбираюсь в AI" та же история.
А если теста под рукой нет, ответьте себе на четыре вопроса про последнюю неделю:
- Агент сам создал или изменил файлы по вашей задаче?
- Есть ли у вас сценарий, который вы повторяете каждую неделю и не объясняете AI заново?
- Что конкретно вы проверили в последнем результате AI, прежде чем отдать его дальше?
- Пользуется ли кто-то, кроме вас, тем, что вы собрали с AI?
"Да" на первые два вопроса - признак уровня 3. Четвёртый вопрос про шаг к уровню 4. А на третий вопрос хорошего ответа "ничего" не бывает ни на одном уровне.
С уровня 1 на уровень 3 за 6 встреч
Интенсив AI Sandbox Lab построен по этой шкале. Встречи 1-2: первый прототип, спецификация и прототип в интернете (уровень 2). Встречи 3-5: память, навыки, свои агенты и подключение сервисов (уровень 3). Встреча 6: демо проектов и план внедрения в команде, первый шаг к уровню 4. Код писать не нужно.
Источники
- Andrej Karpathy. Пост о vibe coding, февраль 2025; о переходе к agentic engineering (Business Insider), февраль 2026.
- Anthropic. Claude Code: Best practices for agentic coding.
- How the creator of Claude Code actually uses Claude Code (разбор практик Бориса Черного).
- Anthropic, Dakan R., Feller J. The AI Fluency Framework, 2025.
- Anthropic. The AI Fluency Index, февраль 2026.
- Anthropic. How AI is transforming work at Anthropic, декабрь 2025.
- OpenAI. Building an AI-native engineering team, 2025.
- EPAM. Investor Day 2026, транскрипт (Д. Товпеко, С. Лафлин, Б. Фейеш), март 2026; Investor Presentation, слайд "Skill Evolution", август 2026.
- EPAM Campus. A!Tech Bootcamp: AI Engineering, 2026.
- Section. AI Proficiency Report, июнь 2026.
- Zapier. AI fluency rubric и обновление 2026.
- Microsoft. Work Trend Index 2025: The Frontier Firm, апрель 2025.
- Dan Shapiro. The Five Levels, январь 2026.
- METR. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, июль 2025.
Read in English · Czytaj po polsku · Чытаць па-беларуску